El judici no es delega · 1 de 12
És fàcil creure que la intel·ligència artificial entén el que li demanem. Qui hagi escrit un missatge des del mòbil té, sense saber-ho, una versió diminuta del mateix mecanisme a la mà. El teclat suggereix la paraula següent, i si s’accepten els suggeriments l’un rere l’altre, sense pensar, apareix a la pantalla una frase sencera, ben construïda, amb el nostre to, però que potser no diu res del que volíem dir. És un eco. Un eco molt probable.
José Antonio Bowen i C. Edward Watson, autors d’una de les guies més difoses sobre docència amb intel·ligència artificial, parteixen d’un punt molt semblant: el cercador fa anys que intenta endevinar el final de les nostres frases a partir del que altres persones van cercar abans. Tanmateix, ningú no ha pensat mai que Google l’entengués. Amb un model de llenguatge la impressió és una altra, ja que respon amb prosa impecable a preguntes que no esperàvem que pogués abordar, i aleshores sembla que qui ens parla és algú.
Aquesta experiència provoca un cert entusiasme inicial i anima molts a tractar la màquina amb les normes de cortesia pròpies entre éssers humans i per descomptat el mateix llenguatge i tipus de diàleg. Saludem en començar, «bona tarda», donem les gràcies i fins i tot ens acomiadem, «ens veiem més tard». I el que és sorprenent és que ens segueix el corrent, però …, és això el més correcte per tenir una conversa útil?
La conversa educativa sobre intel·ligència artificial ensopega gairebé sempre amb el mateix problema de base, i és que es decideix sobre una cosa que no s’ha entès en profunditat. Aquest primer article s’ocupa del principi del recorregut.
Què fa exactament la màquina quan parla?
El truc és a l’aposta
Un model de llenguatge no cerca informació ni consulta un magatzem de coneixement. Prediu la paraula següent. Aquesta és tota l’operació, repetida milions de vegades. La imatge de l’aposta descriu bé el que passa. El model aposta per la paraula més probable, l’escriu, i torna a apostar donant per bona la seva aposta anterior. Mai no es pregunta si ha encertat. Només continua.
Per poder fer-ho, el text es converteix abans en nombres, ja que una xarxa neuronal només treballa amb nombres. Aquestes unitats mínimes s’anomenen tokens, i representen paraules, fragments de paraula, caràcters o signes de puntuació. El model rep una seqüència de tokens i calcula, sobre tot el vocabulari disponible, quin és el que té més probabilitat de seguir.
El text es descompon en tokens numèrics perquè la xarxa calculi estadísticament la següent aposta.
Aquest mecanisme probabilístic es pot comprovar des de fora. Bowen i Watson descriuen un ajust intern que els desenvolupadors anomenen temperatura: quan es configura a zero, el model tria sempre la paraula més probable i les seves respostes es tornen previsibles; quan s’augmenta, comença a seleccionar paraules menys probables, i amb elles arriben alhora l’originalitat i el disbarat. És un únic ajust per a totes dues coses. No hi ha un comandament per al que és interessant i un altre per al que és encertat, i aquest detall explica bona part del que veurem en el proper article «Sense llum d’avís».
Aquest funcionament, per si sol, no explica el que veiem a la pantalla. Un predictor de paraules fa anys que és al teclat del mòbil i ningú no el confon amb un interlocutor. El que separa l’un de l’altre és l’escala, i l’escala té dues mesures. La primera és el text amb què s’entrena: quaranta-cinc terabytes en el cas de GPT-3, més de dotze bilions de paraules. La segona són els paràmetres, les variables internes que s’ajusten durant l’entrenament. No compten paraules, compten ajustos. GPT-2 tenia mil cinc-cents milions de paràmetres; GPT-3 va arribar a més de cent vegades aquesta xifra. El mecanisme va continuar sent el mateix. L’única cosa que va créixer va ser la mida.
El 2017 s’hi va afegir a més una arquitectura, el transformador, que permet comparar cada token amb tots els altres de la seqüència alhora, i no l’un darrere l’altre. Més context, més matís, més velocitat. Cap comprensió.
L’èxit actual no prové de la comprensió, sinó d’un increment gegantí d’escala i paràmetres.
Mapes sense territori
Si l’operació és tan simple, per què encerta tant? Dirk Wulff, de l’Institut Max Planck per al Desenvolupament Humà de Berlín, i Rui Mata, de la Universitat de Basilea, van publicar el 2026 a Trends in Cognitive Sciences una revisió del que aquests sistemes poden aportar a la ciència cognitiva. La seva definició és sòbria: sistemes computacionals entrenats amb text per aprendre regularitats estadístiques del llenguatge. I hi afegeixen una cosa decisiva. A més de predir, aquests sistemes converteixen el text en representacions numèriques anomenades embeddings, que situen paraules i frases en un espai de moltes dimensions on la proximitat correspon a la similitud de significat.
Aquí hi ha la resposta. El que l’entrenament produeix no és coneixement del món, sinó un mapa de proximitats entre les coses que les persones han dit sobre el món. Un mapa molt detallat, construït sobre una porció enorme de llenguatge humà, en què «docent» queda a prop d’«aula» i lluny de «turbina». Amb un mapa així es recorre moltíssim territori sense haver-ne trepitjat mai cap. Aquest mapa dona resultats que sorprenen fins i tot els qui el construeixen. Wulff i Mata recorden que aquests models resolen tasques molt diverses sense haver estat entrenats per a cadascuna.
El cas més discutit és un model anomenat Centaur. Marcel Binz i el seu equip el van presentar el 2025 a la revista Nature: el van entrenar amb una col·lecció molt àmplia de dades de conducta humana, procedents d’experiments sobre memòria, aprenentatge i presa de decisions. El model va acabar predient com decidirien les persones en tasques que no havia vist mai. El resultat és notable, i els mateixos Wulff i Mata el matisen de seguida de tres maneres. El model es desestabilitza davant variacions petites de l’enunciat. Les seves representacions internes continuen sent opaques. I hi ha investigadors que qüestionen de soca-rel que cap model actual ens pugui ensenyar res sobre la ment humana.
Aquest és l’estat real de la discussió, i val la pena traslladar-lo al claustre tal com és. La pregunta seriosa no és si la màquina entén. És quina representació del món pot construir un sistema que només ha vist text, i fins on arriba aquesta representació quan el que cal explicar són processos que depenen del cos, de la percepció i de l’acció. Wulff i Mata la deixen plantejada com a pregunta oberta, no com a conclusió.
Per què ens convenç
El 1950, Alan Turing es va preguntar si les màquines poden pensar i va descartar la seva pròpia pregunta per imprecisa. La va substituir per un joc: un interrogador conversa per escrit amb dos interlocutors i intenta esbrinar quin dels dos és humà. Bowen i Watson ho resumeixen sense embuts: el que el test mesura és si «aquest xatbot ens pot fer creure que interactuem amb un humà». El 2022, un enginyer de Google va ser acomiadat després de sostenir públicament que el xatbot de l’empresa s’havia tornat conscient. No va caldre que la màquina pensés. N’hi va haver prou que ho semblés.
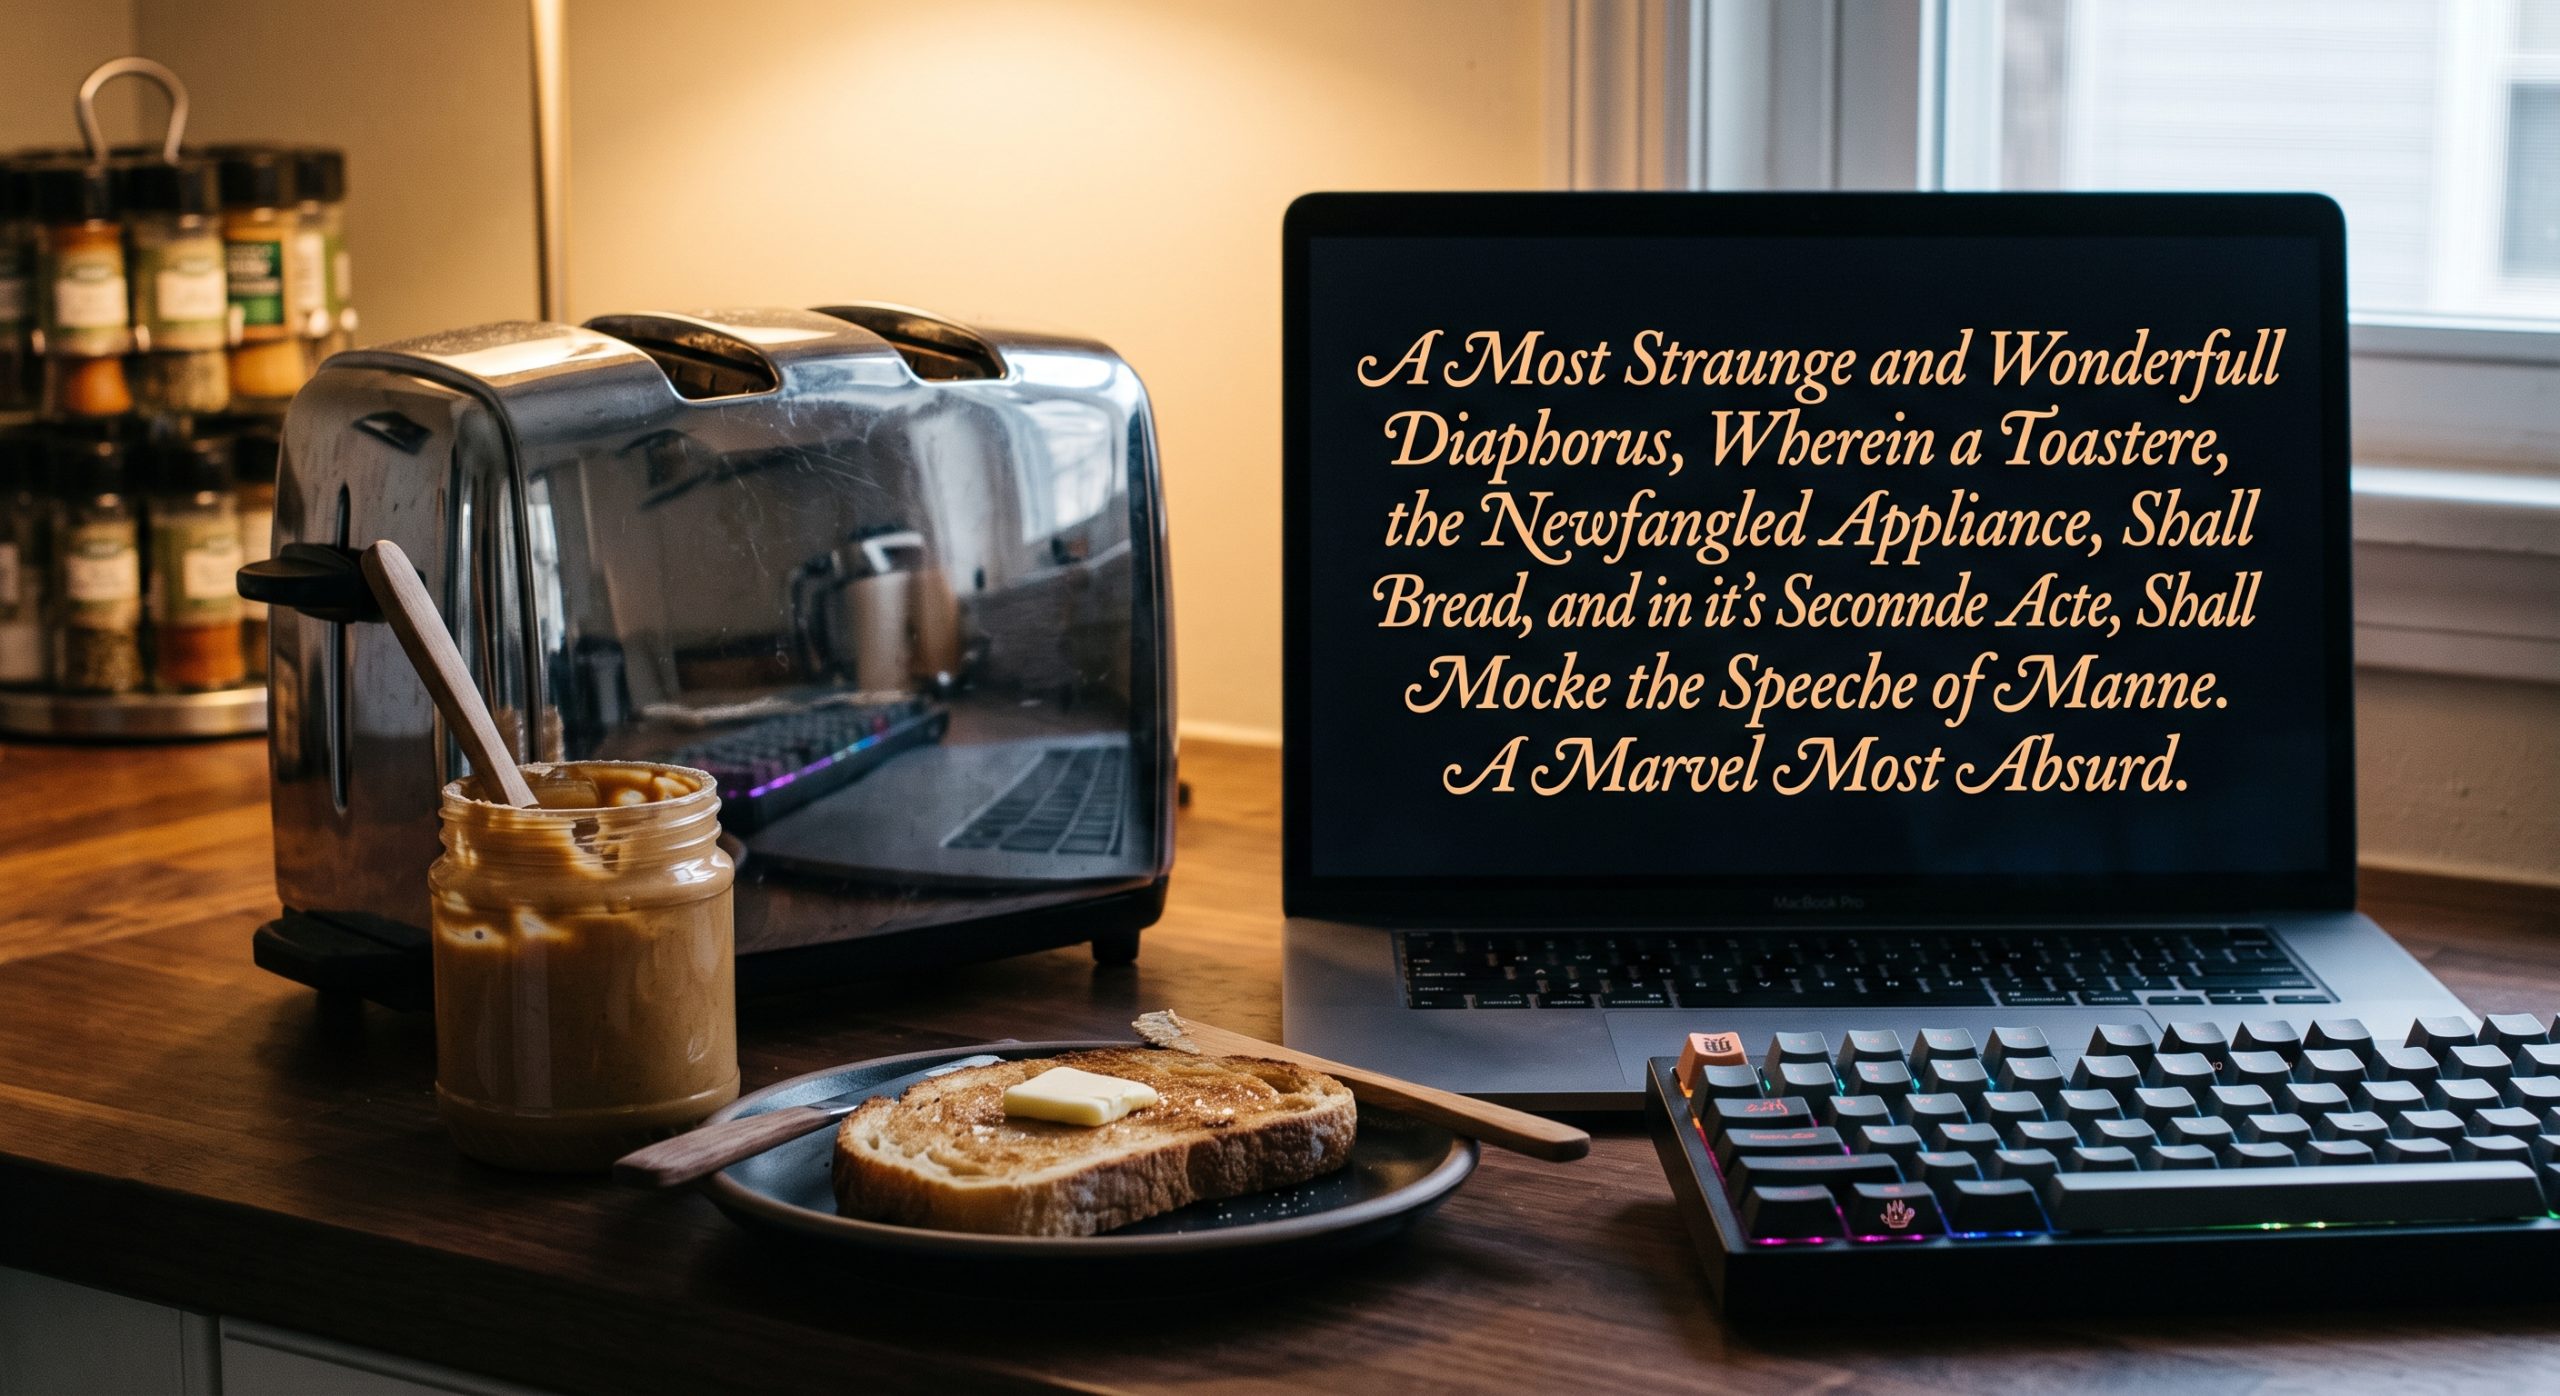
El que la màquina fa bé, doncs, és sonar a persona. No és un efecte secundari, és justament allò per a què se la va entrenar: produir la continuació més plausible d’un text escrit per humans. Bowen i Watson ho demostren amb un encàrrec deliberadament absurd: un procediment de dues-centes paraules per treure de la torradora un sandvitx de mantega de cacauet, escrit a l’estil de la Bíblia del rei Jaume, versió anglesa de 1611 la prosa de la qual sona a versicle. El model va respondre en aquest registre, amb el sandvitx atrapat a les profunditats de l’aparell i el poble consternat per no poder-se’l menjar. Els autors assenyalen de seguida on hi havia allò nou: en la combinació de les tres peces, el sandvitx, la torradora i l’estil bíblic, que només se li podia haver acudit a una persona. La màquina va contestar més de pressa del que hauria contestat qualsevol de nosaltres, i això és cert. La novetat l’havia posada la petició, no la resposta. La màquina no sabia res de torradores ni de teologia. Sabia quines paraules solen seguir quan algú escriu així.
La creativitat prové de la petició humana; la màquina només enllaça paraules coherents amb el registre.
Queda encara una objecció més seriosa, i convé no menystenir-la. Alejandro Espeso-García, de la Universitat Catòlica de Múrcia, sosté en un article de 2025 que aquests sistemes no es limiten a executar tasques, sinó que «emulen processos de raonament». És cert que els models més recents encadenen passos intermedis abans de respondre, i que això els permet resoldre problemes de diversos moviments i actuar amb força autonomia.
Però aquests passos també s’aprenen. Wulff i Mata expliquen el procediment: s’entrena el model per reforç, premiant les cadenes de passos que porten a un resultat comprovable. El que passa dins d’aquestes cadenes continua sent opac fins i tot per als qui construeixen els models, i encertar molt no garanteix explicar res, adverteixen aquests mateixos autors. Emular un procés i dur-lo a terme no és el mateix.
Hi ha una conseqüència de tot això que mereix un article propi: un sistema que calcula el més probable produeix falsedats amb la mateixa fluïdesa i el mateix aplom amb què produeix veritats.
Encadenar passos lògics emula el raonament, però no dissipa l’opacitat del seu mecanisme intern.
Què fer amb això a l’escola
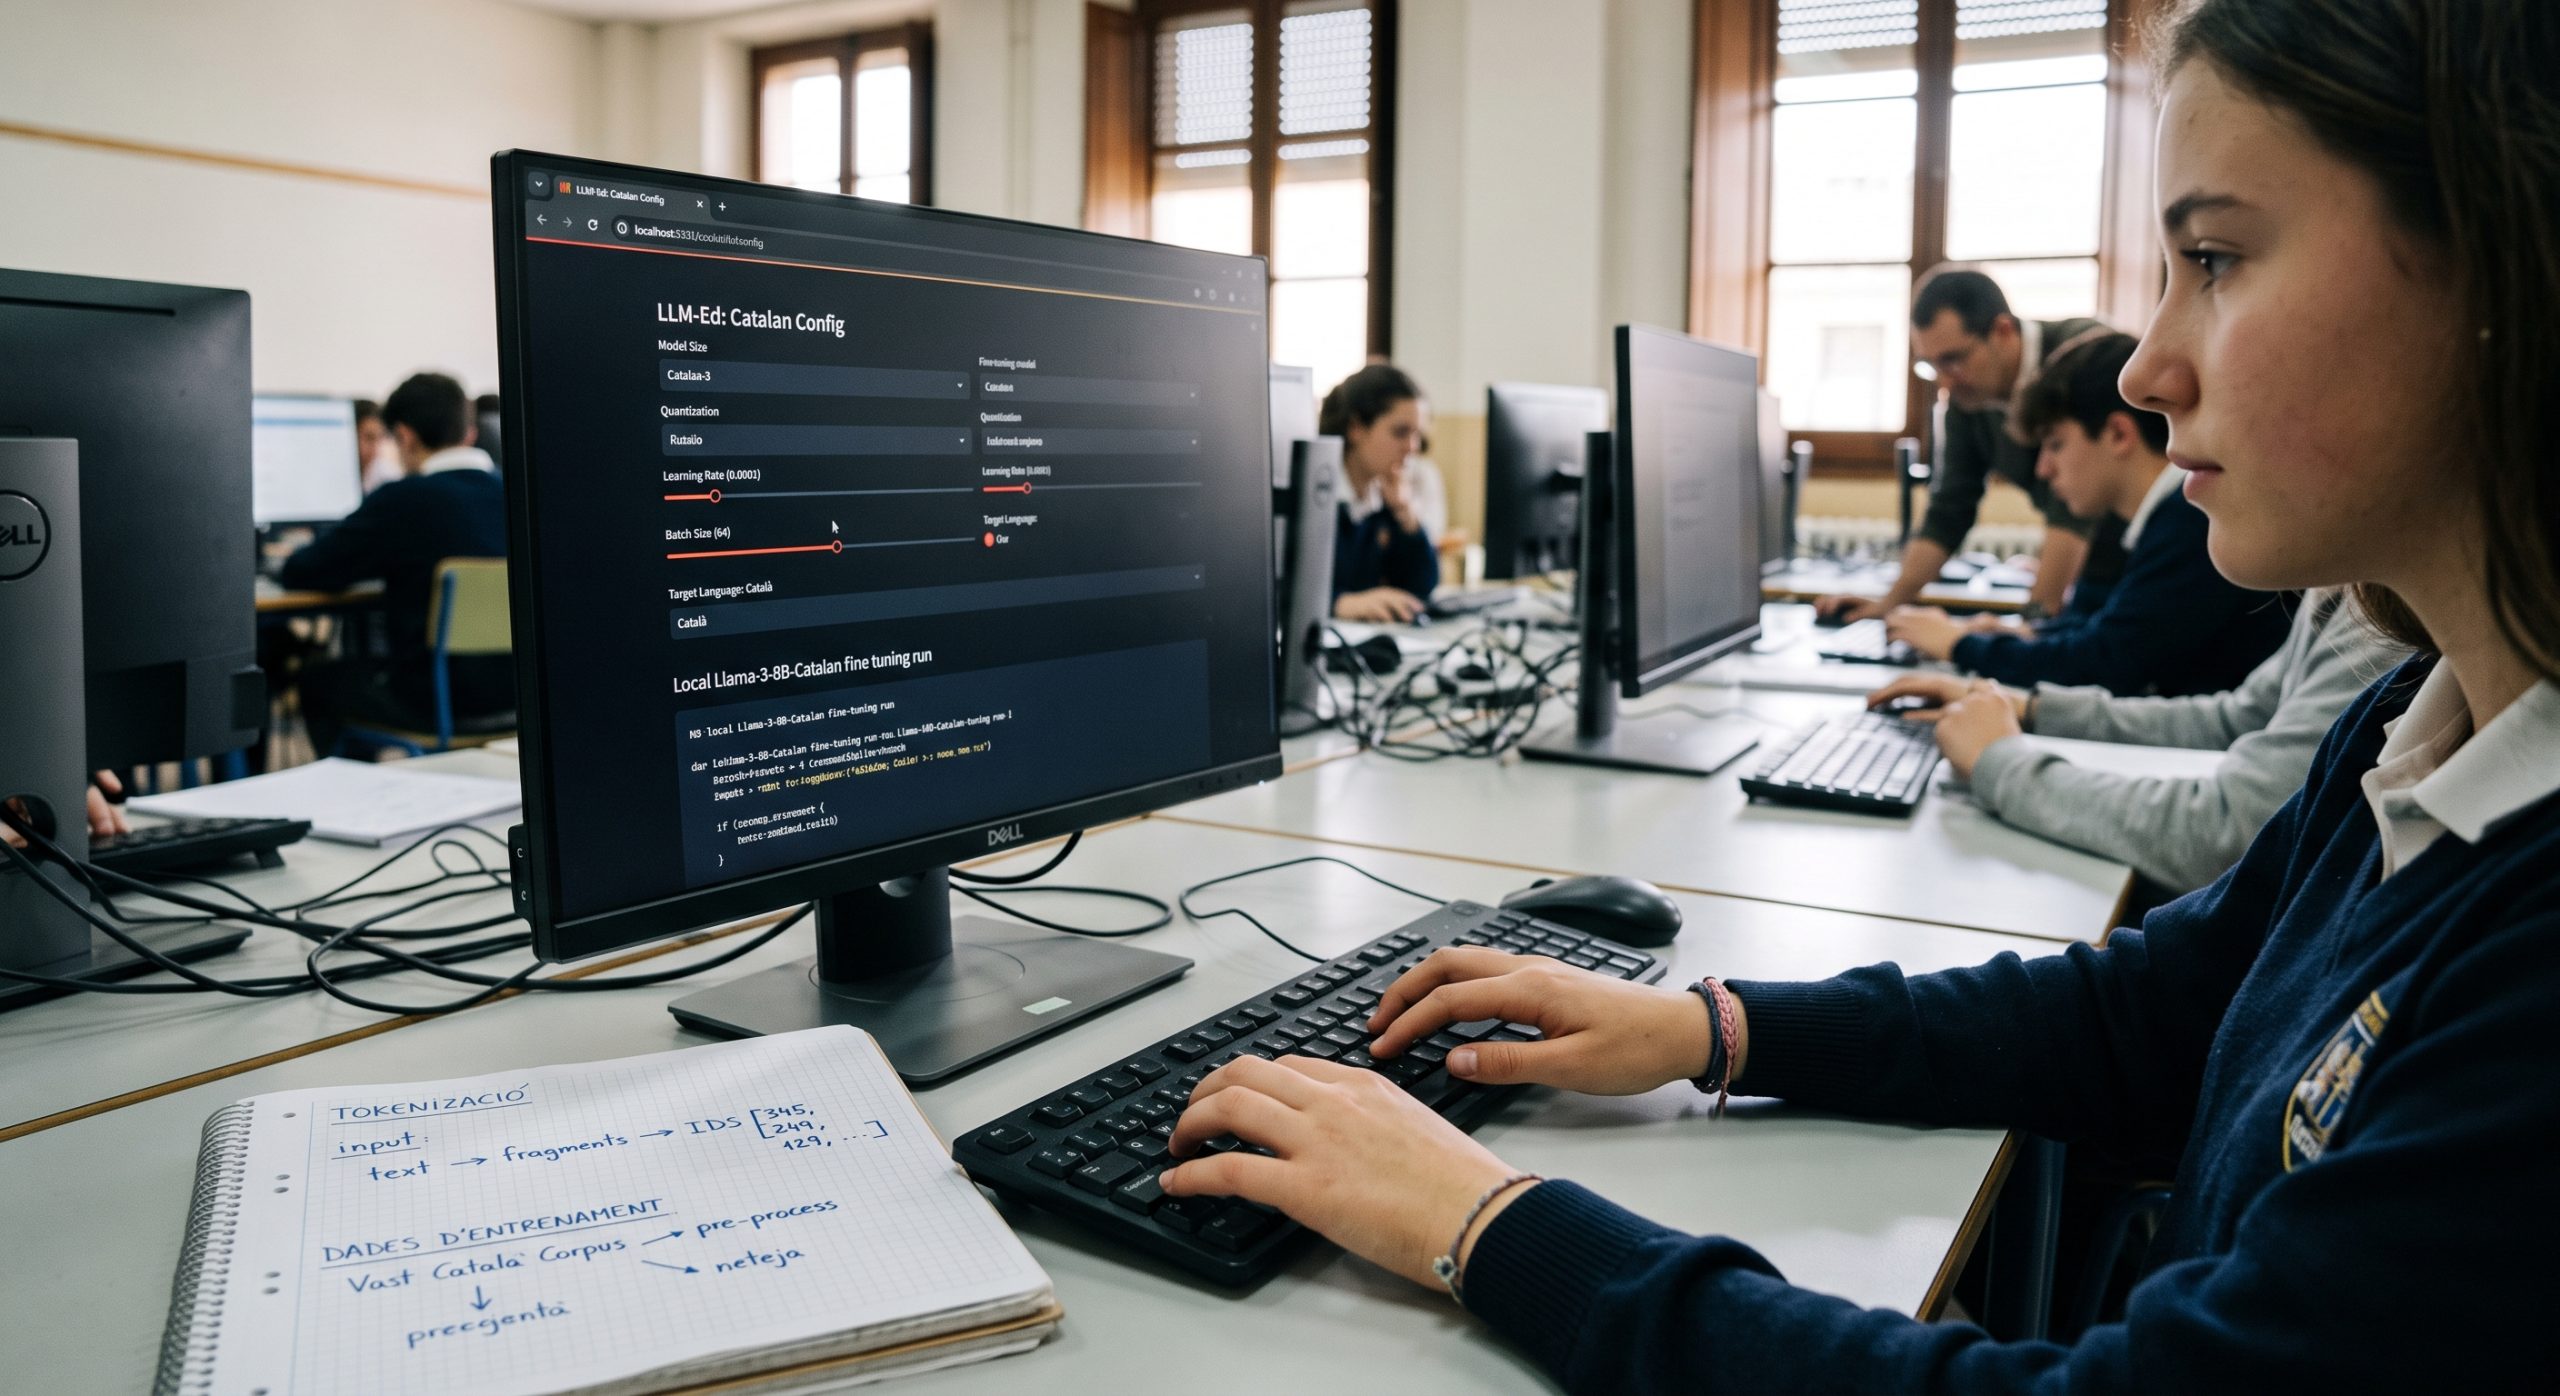
A l’aula. El projecte finlandès Generation AI ofereix una eina anomenada Little Language Machine, un entorn al navegador on l’alumnat entrena el seu propi model de llenguatge, un transformador real molt més petit que els comercials. S’executa en local i no envia dades a servidors externs. Qui la fa servir veu el model passar de seqüències de caràcters a l’atzar a un text cada vegada més coherent, i pot modificar les dades d’entrenament, la mida del model i l’aleatorietat per observar què canvia. L’eina és en beta oberta des de 2025 i se’n preveu la publicació per a la tardor de 2026, de manera que convé provar-la abans de portar-la a classe.
A l’aula. Repetir l’experiment de la torradora amb un encàrrec propi, disbaratat i molt específic, i demanar a l’alumnat que localitzi on era exactament la creativitat.
Per a l’equip directiu. Un guió de deu minuts, per a claustre o per a reunió de famílies, amb les tres idees d’aquest post: la màquina prediu, el mapa no és el territori, la fluïdesa convenç. Amb una precaució. En un estudi Delphi internacional publicat el 2026 i dirigit per Jonas Hallström, catedràtic de didàctica de la tecnologia a la Universitat de Linköping, el panell d’experts va rebutjar amb claredat la idea que aprendre sobre intel·ligència artificial consisteixi sobretot a utilitzar aplicacions generatives de text com ChatGPT: aquesta afirmació va obtenir una mitjana de 2,037 sobre 5. Alfabetitzar no consisteix únicament a obrir comptes i ensenyar a redactar peticions.
L’alfabetització en IA requereix entendre els fonaments tècnics en lloc d’aprendre només a redactar peticions.
Per acabar
Aquest mateix estudi sosté que la comprensió tècnica és «requisit previ per ser crític i ètic» amb la intel·ligència artificial. Aquesta és la raó per la qual aquesta sèrie comença per la màquina i no per les polítiques de centre. Convé afegir, en honor de la precisió, que el panell no va arribar a consensuar que calgui obrir del tot la caixa negra: aquesta afirmació es va descartar per manca d’acord entre els experts. El desacord és en quanta profunditat tècnica cal, no en si en cal alguna. Entendre el mecanisme no és un argument contra la tecnologia. És la condició per poder-la discutir.
Per continuar pensant. Si demà la màquina encertés sempre, canviaria alguna cosa del que hem vist aquí? I una segona pregunta, més incòmoda: de les decisions que hem pres aquest curs sobre intel·ligència artificial, quines depenien de creure que pensava realment?
Comprendre el funcionament intern de la tecnologia és la condició bàsica per regular-la i avaluar-la.
Valora el post
Et pot interessar