El juicio no se delega· 1 de 12
Es fácil creer que la inteligencia artificial entiende lo que le pedimos. Quien haya escrito un mensaje desde el móvil tiene, sin saberlo, una versión diminuta del mismo mecanismo en la mano. El teclado sugiere la palabra siguiente, y si se aceptan las sugerencias una tras otra, sin pensar, aparece en la pantalla una frase entera, bien construida, con nuestro tono, pero que quizás no dice nada de lo que queríamos decir. Es un eco. Un eco muy probable.
José Antonio Bowen y C. Edward Watson, autores de una de las guías más difundidas sobre docencia con inteligencia artificial, parten desde un punto muy similar: el buscador lleva años intentando adivinar el final de nuestras frases a partir de lo que otras personas buscaron antes. Sin embargo, nadie ha pensado nunca que Google le entendiera. Con un modelo de lenguaje la impresión es otra, pues responde con prosa impecable a preguntas que no esperábamos que pudiera abordar, y entonces parece que quien nos habla es alguien.
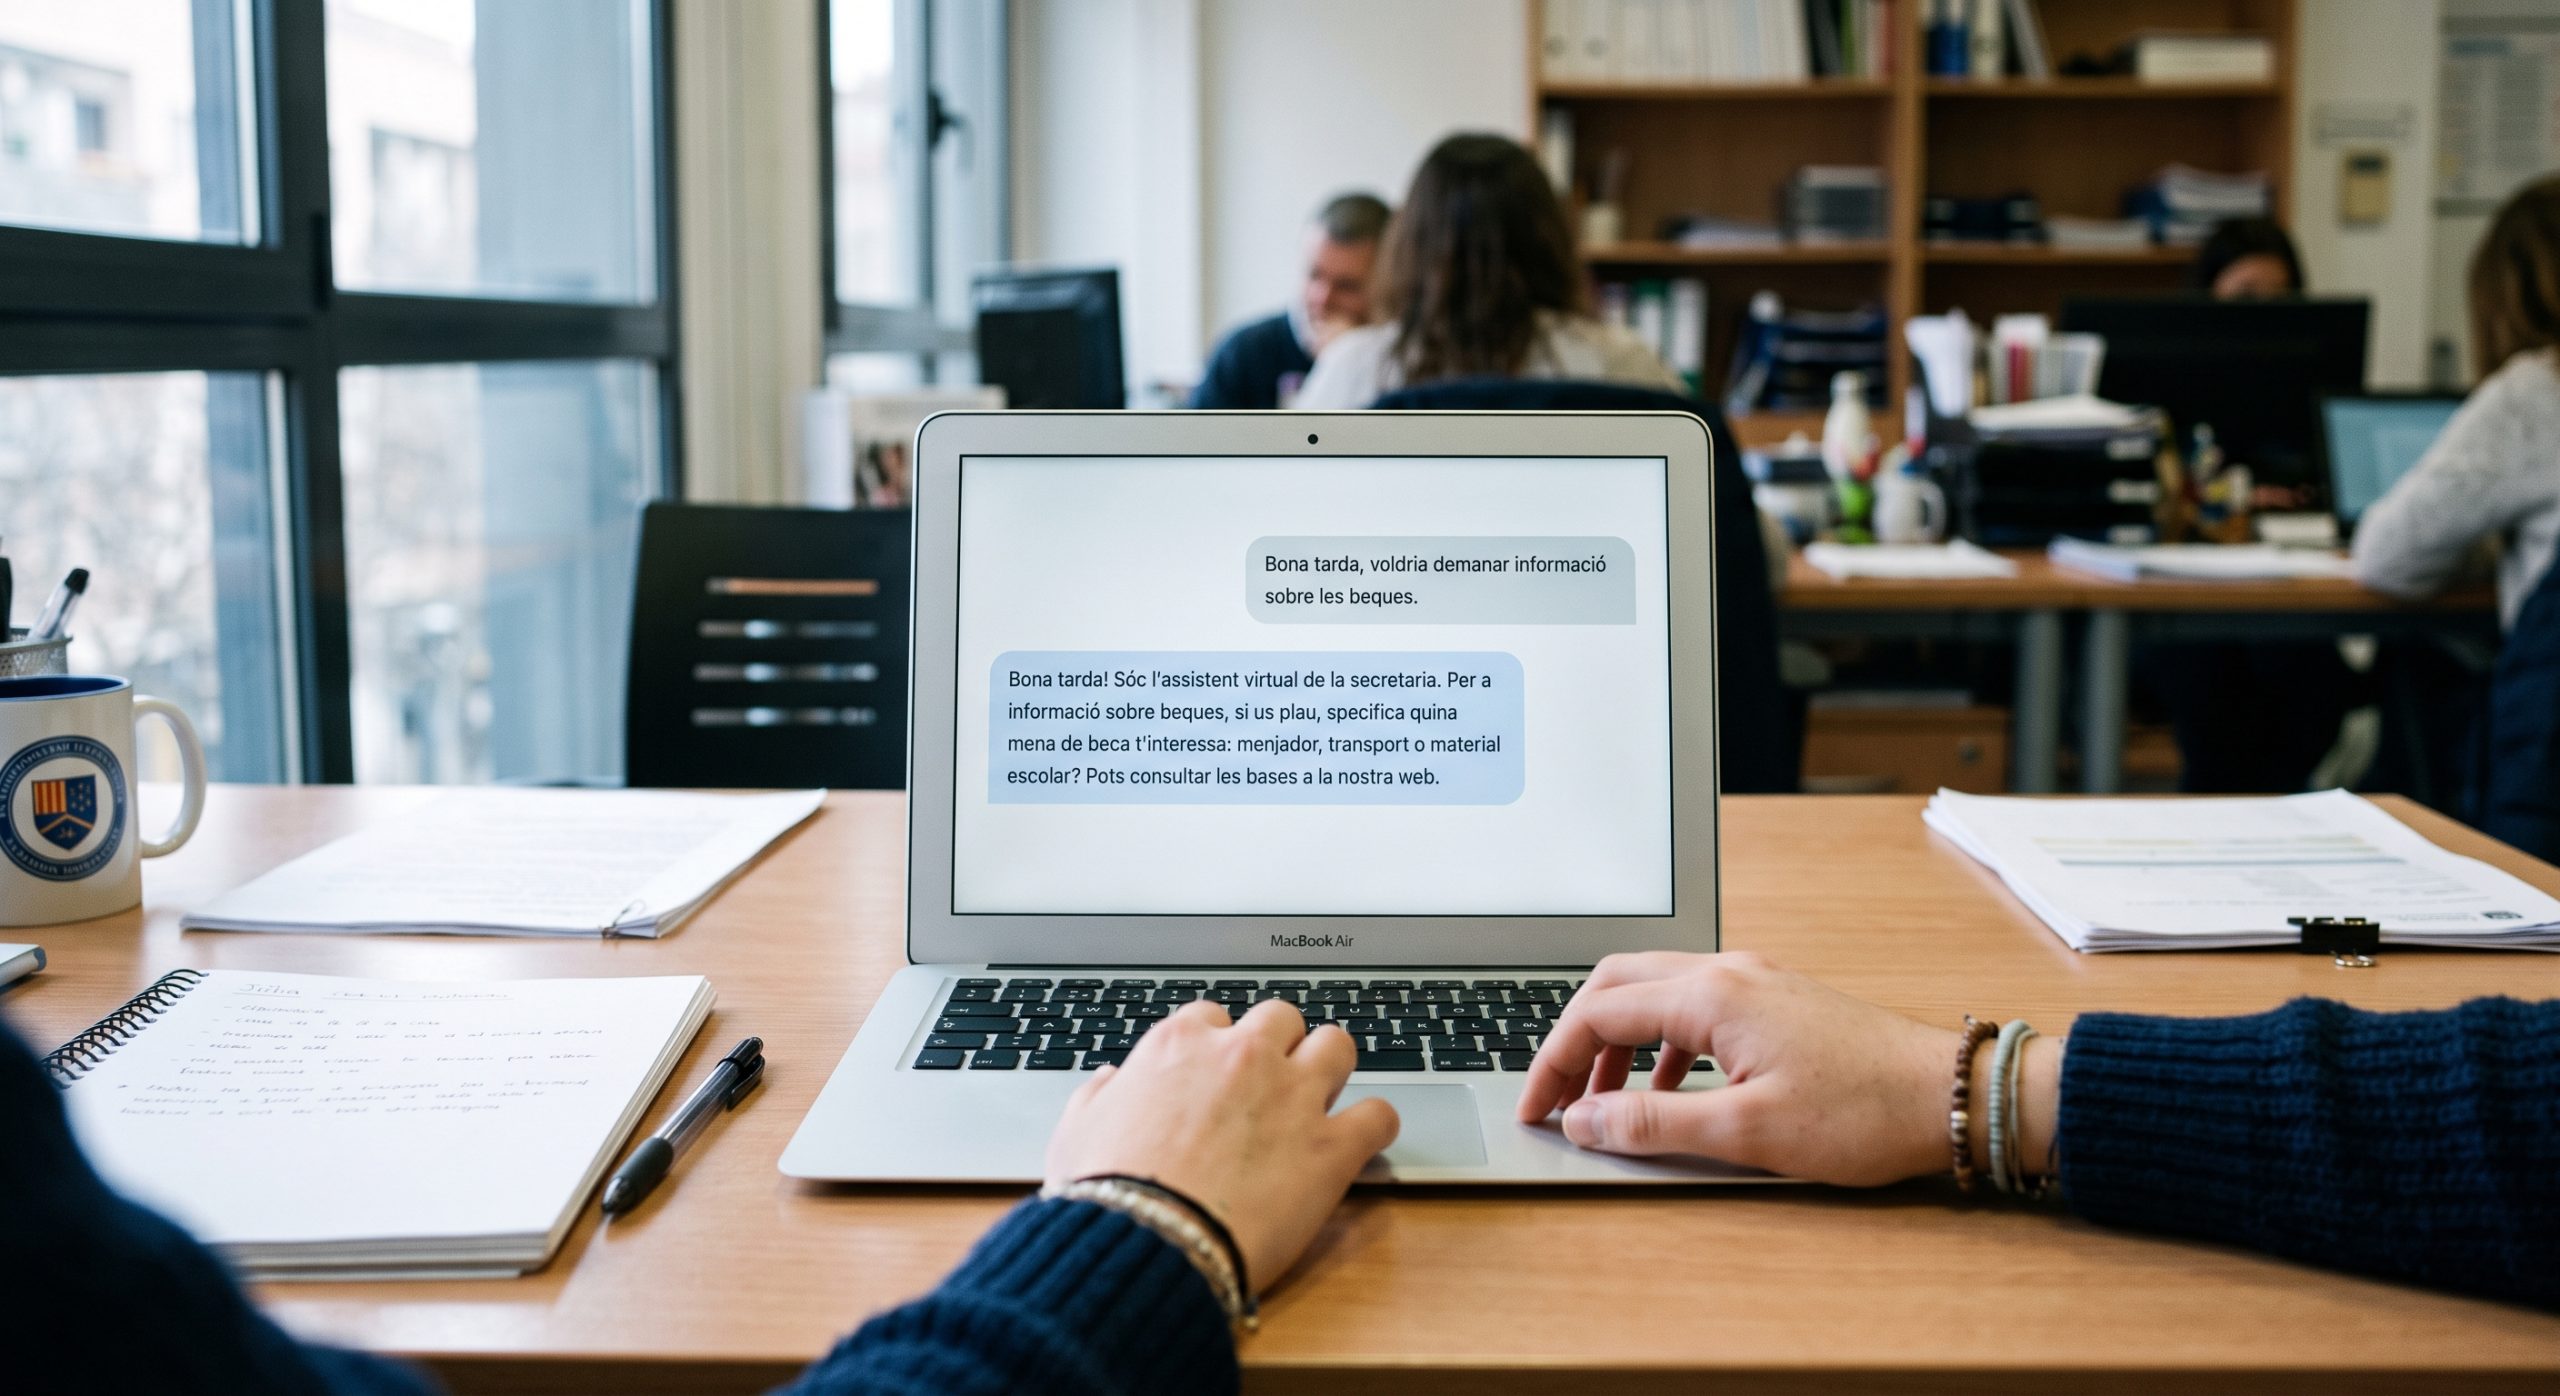
Esta experiencia provoca un cierto entusiasmo inicial y anima a muchos a tratar a la máquina con las normas de cortesía propia entre seres humanos y por supuesto el mismo lenguaje y tipo de diálogo. Saludamos al empezar, “buenas tardes”, damos las gracias e incluso nos despedimos, “nos vemos más tarde”. Y lo asombroso es que nos sigue la cuerda, pero …, ¿es esto lo más correcto para tener una conversación útil?
La conversación educativa sobre inteligencia artificial tropieza casi siempre con el mismo problema de base, y es que se decide sobre algo que no se ha entendido en profundidad. Este primer artículo se ocupa del principio del recorrido.
¿Qué hace exactamente la máquina cuando habla?
El truco está en la apuesta
Un modelo de lenguaje no busca información ni consulta un almacén de conocimiento. Predice la palabra siguiente. Esa es toda la operación, repetida millones de veces.
La imagen de la apuesta describe bien lo que ocurre. El modelo apuesta por la palabra más probable, la escribe, y vuelve a apostar dando por buena su apuesta anterior. Nunca se pregunta si acertó. Solo continúa.
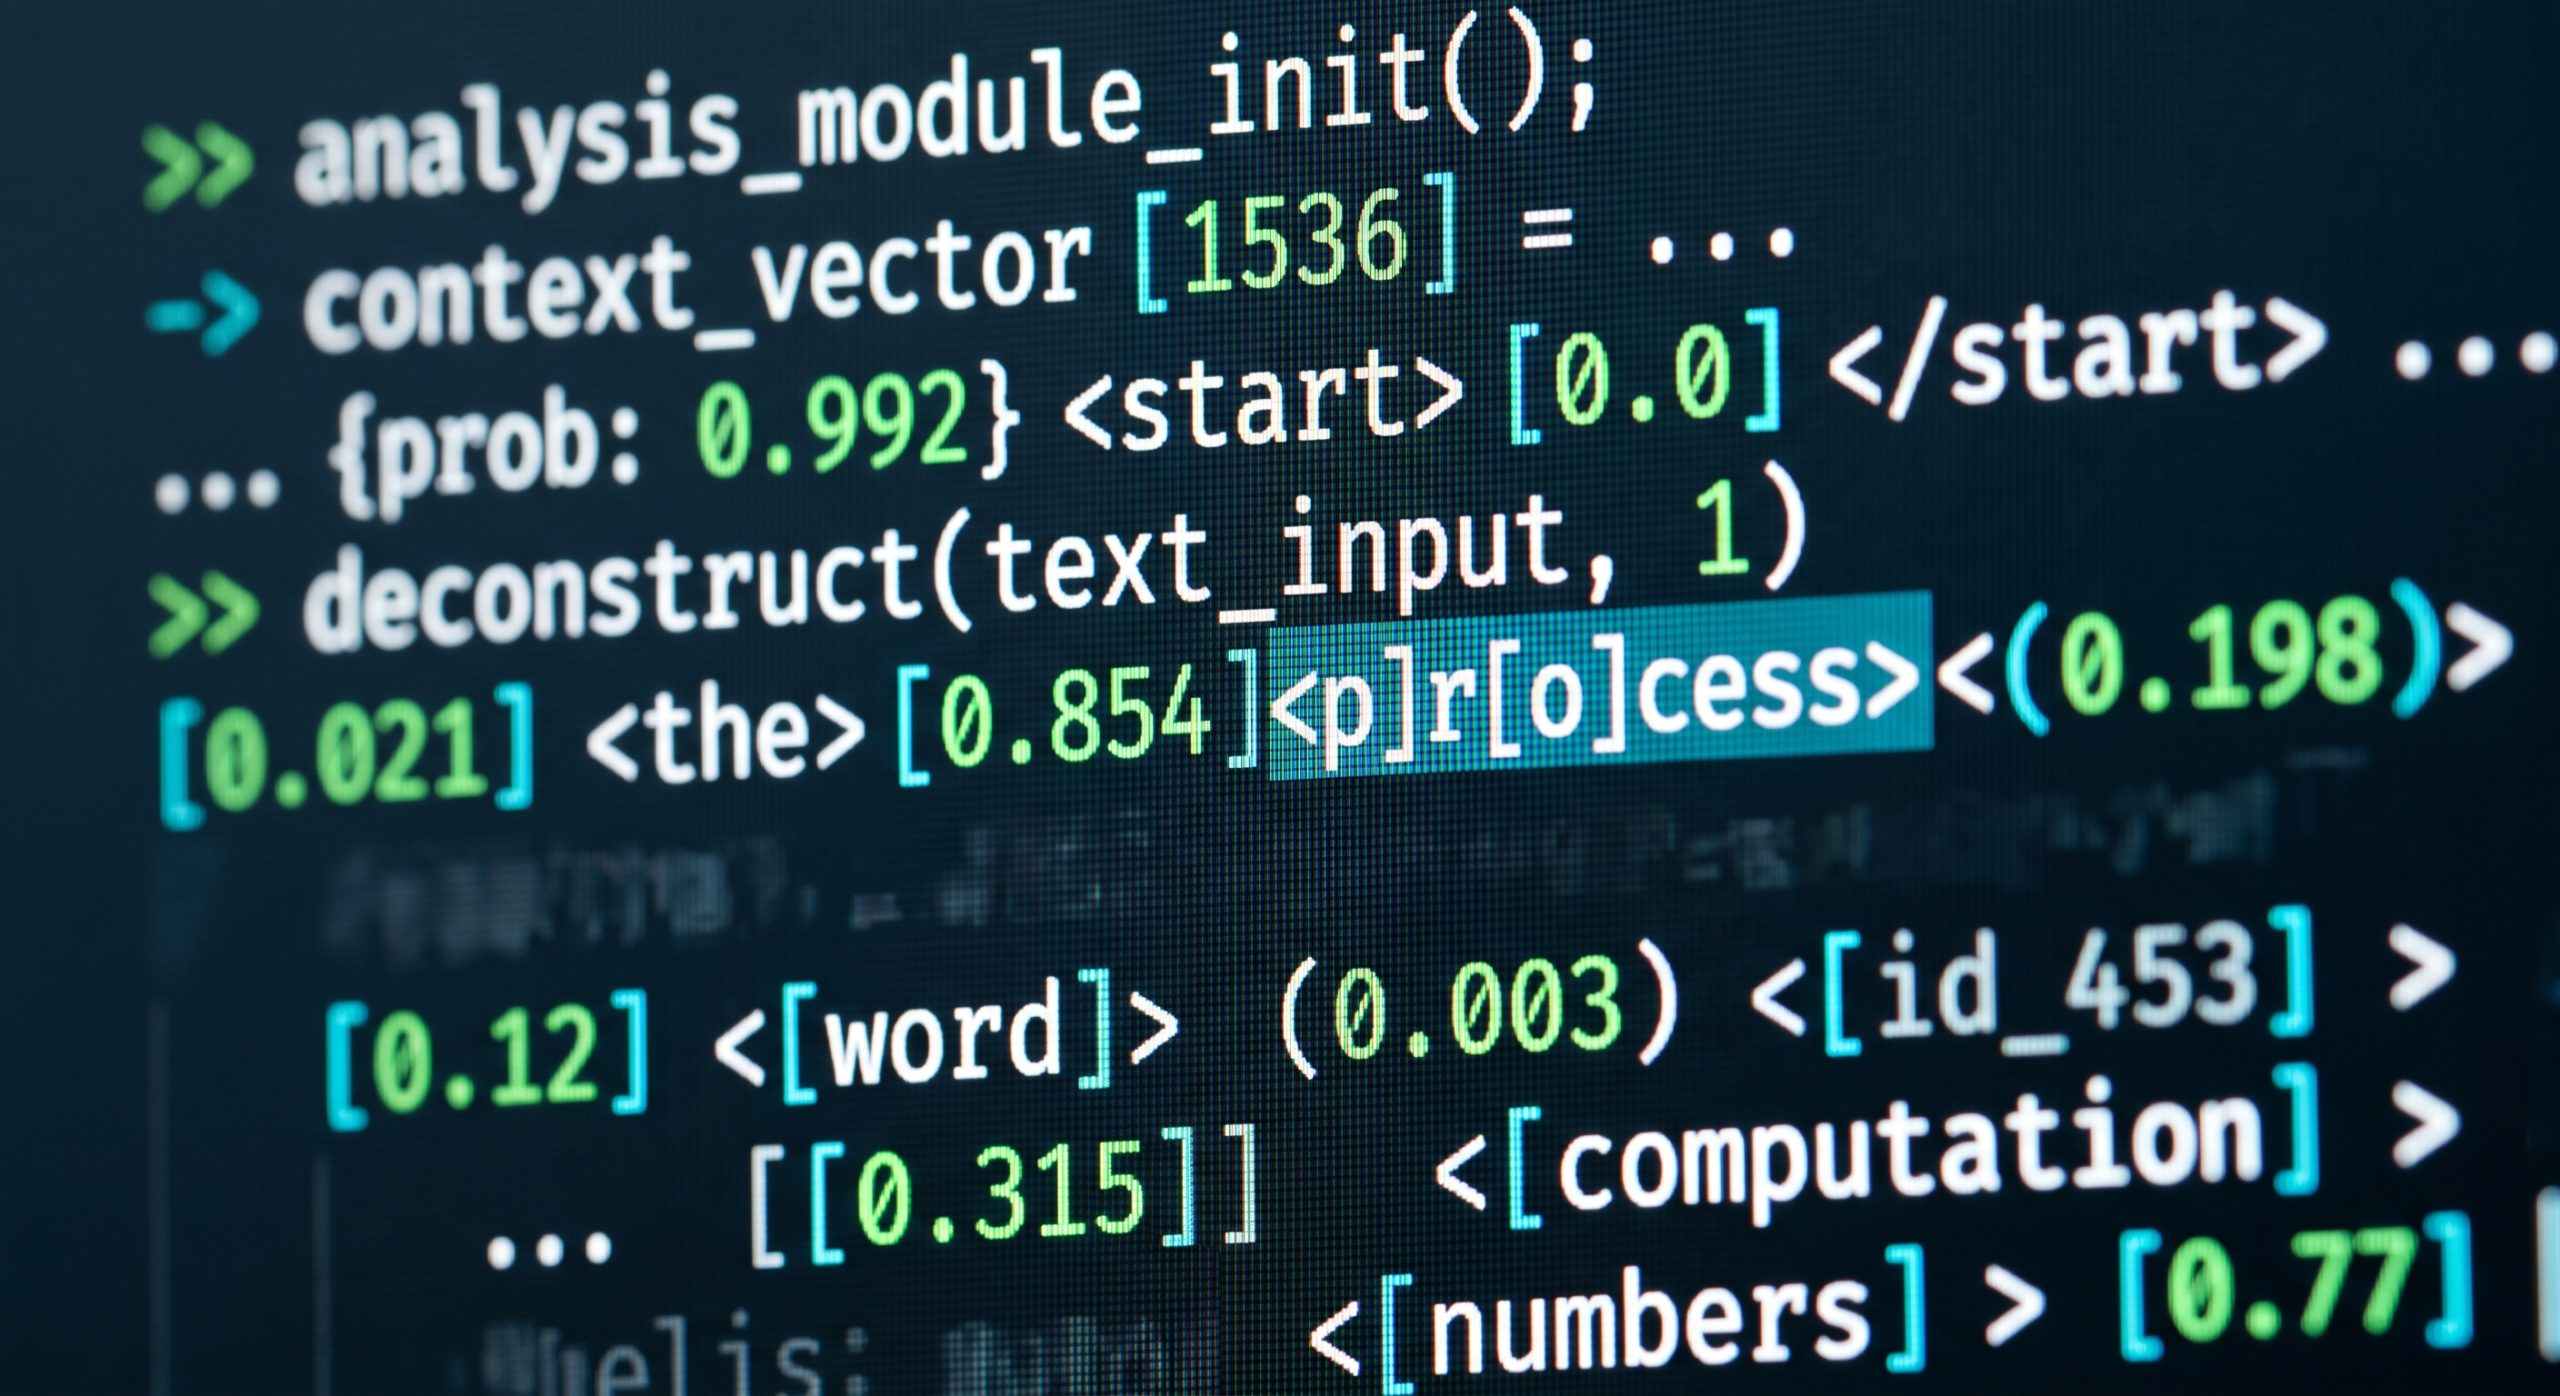
Para poder hacerlo, el texto se convierte antes en números, pues una red neuronal solo trabaja con números. A esas unidades mínimas se las llama tokens, y representan palabras, fragmentos de palabra, caracteres o signos de puntuación. El modelo recibe una secuencia de tokens y calcula, sobre todo el vocabulario disponible, cuál es el que tiene más probabilidad de seguir.
El texto se descompone en tokens numéricos para que la red calcule estadísticamente la siguiente apuesta.
Este mecanismo probabilístico se puede comprobar desde fuera. Bowen y Watson describen un ajuste interno que los desarrolladores llaman temperatura: cuando se configura a cero, el modelo escoge siempre la palabra más probable y sus respuestas se vuelven previsibles; cuando se aumenta, empieza a seleccionar palabras menos probables, y con ellas llegan a la vez la originalidad y el disparate. Es un único ajuste para las dos cosas. No hay un mando para lo interesante y otro para lo acertado, y ese detalle explica buena parte de lo que veremos en el próximo artículo “Sin luz de aviso”.
Este funcionamiento, por sí solo, no explica lo que vemos en pantalla. Un predictor de palabras lleva años en el teclado del móvil y nadie lo confunde con un interlocutor. Lo que separa a uno de otro es la escala, y la escala tiene dos medidas. La primera es el texto con el que se entrena: cuarenta y cinco terabytes en el caso de GPT-3, más de doce billones de palabras. La segunda son los parámetros, las variables internas que se ajustan durante el entrenamiento. No cuentan palabras, cuentan ajustes. GPT-2 tenía mil quinientos millones de parámetros; GPT-3 llegó a más de cien veces esa cifra. El mecanismo siguió siendo el mismo. Lo único que creció fue el tamaño.
En 2017 se añadió además una arquitectura, el transformador, que permite comparar cada token con todos los demás de la secuencia a la vez, y no uno detrás de otro. Más contexto, más matiz, más velocidad. Ninguna comprensión.
El éxito actual no proviene de la comprensión, sino de un incremento gigantesco de escala y parámetros.
Mapas sin territorio
Si la operación es tan simple, ¿por qué acierta tanto?
Dirk Wulff, del Instituto Max Planck para el Desarrollo Humano de Berlín, y Rui Mata, de la Universidad de Basilea, publicaron en 2026 en Trends in Cognitive Sciences una revisión de lo que estos sistemas pueden aportar a la ciencia cognitiva. Su definición es sobria: sistemas computacionales entrenados con texto para aprender regularidades estadísticas del lenguaje. Y añaden algo decisivo. Además de predecir, esos sistemas convierten el texto en representaciones numéricas llamadas embeddings, que sitúan palabras y frases en un espacio de muchas dimensiones donde la proximidad corresponde a la similitud de significado (2).
Ahí está la respuesta. Lo que el entrenamiento produce no es conocimiento del mundo, sino un mapa de proximidades entre las cosas que las personas han dicho sobre el mundo. Un mapa muy detallado, construido sobre una porción enorme de lenguaje humano, en el que “docente” queda cerca de “aula” y lejos de “turbina”. Con un mapa así se recorre muchísimo territorio sin haber pisado nunca ninguno.
Ese mapa da resultados que sorprenden incluso a quienes lo construyen. Wulff y Mata recuerdan que estos modelos resuelven tareas muy diversas sin haber sido entrenados para cada una de ella. El caso más discutido es un modelo llamado Centaur. Marcel Binz y su equipo lo presentaron en 2025 en la revista Nature: lo entrenaron con una colección muy amplia de datos de conducta humana, procedentes de experimentos sobre memoria, aprendizaje y toma de decisiones. El modelo terminó prediciendo cómo decidirían las personas en tareas que nunca había visto.
El resultado es notable, y los propios Wulff y Mata lo matizan enseguida de tres formas. El modelo se desestabiliza ante variaciones pequeñas del enunciado. Sus representaciones internas siguen siendo opacas. Y hay investigadores que cuestionan de raíz que ningún modelo actual pueda enseñarnos algo sobre la mente humana.
Ese es el estado real de la discusión, y merece la pena trasladarlo al claustro tal cual es. La pregunta seria no es si la máquina entiende. Es qué representación del mundo puede construir un sistema que solo ha visto texto, y hasta dónde llega esa representación cuando lo que hay que explicar son procesos que dependen del cuerpo, de la percepción y de la acción. Wulff y Mata la dejan planteada como pregunta abierta, no como conclusión.
Por qué nos convence
En 1950, Alan Turing se preguntó si las máquinas pueden pensar y descartó su propia pregunta por imprecisa. La sustituyó por un juego: un interrogador conversa por escrito con dos interlocutores y trata de averiguar cuál de los dos es humano. Bowen y Watson lo resumen sin rodeos: lo que el test mide es si “este chatbot puede hacernos creer que interactuamos con un humano”. En 2022, un ingeniero de Google fue despedido tras sostener públicamente que el chatbot de la empresa se había vuelto consciente. No hizo falta que la máquina pensara. Bastó con que lo pareciera.
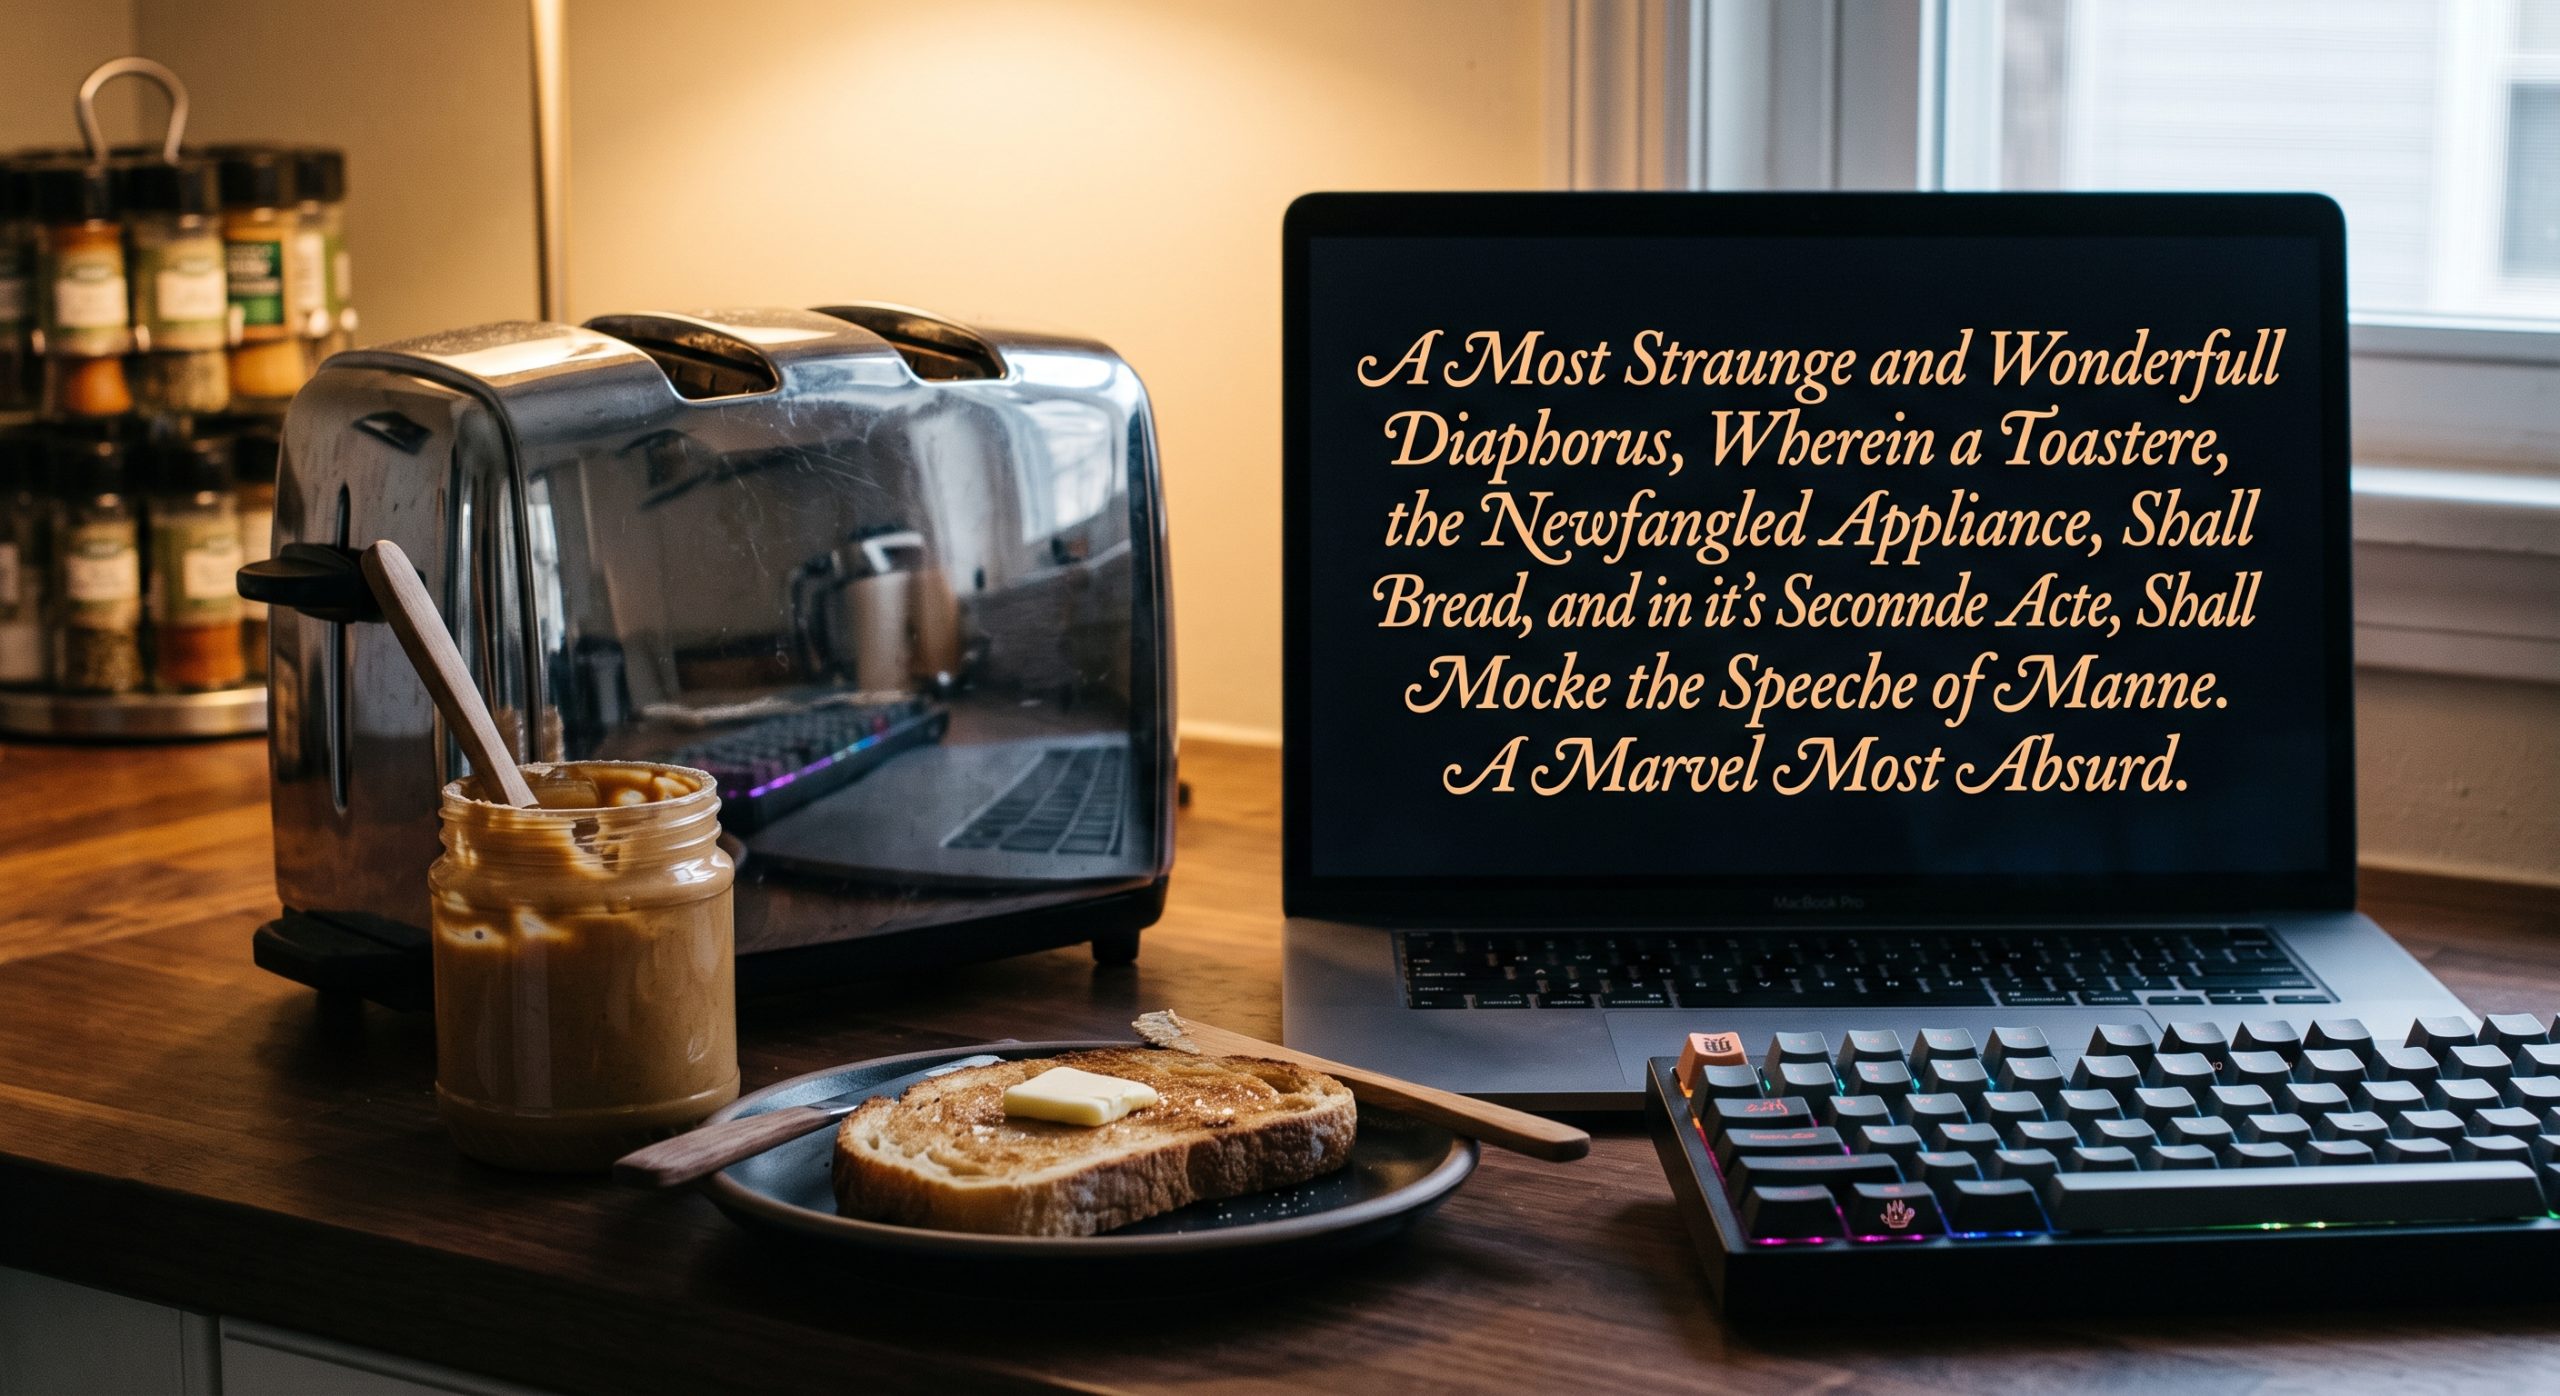
Lo que la máquina hace bien, entonces, es sonar a persona. No es un efecto secundario, es justamente aquello para lo que se la entrenó: producir la continuación más plausible de un texto escrito por humanos. Bowen y Watson lo demuestran con un encargo deliberadamente absurdo: un procedimiento de doscientas palabras para sacar de la tostadora un sándwich de mantequilla de cacahuete, escrito al estilo de la Biblia del rey Jacobo, versión inglesa de 1611 cuya prosa suena a versículo. El modelo respondió en ese registro, con el sándwich atrapado en las profundidades del aparato y el pueblo consternado por no poder comérselo. Los autores señalan enseguida dónde estaba lo nuevo: en la combinación de las tres piezas, el sándwich, la tostadora y el estilo bíblico, que solo podía habérsele ocurrido a una persona. La máquina contestó más deprisa de lo que habría contestado cualquiera de nosotros, y eso es cierto. La novedad la había puesto la petición, no la respuesta. La máquina no sabía nada de tostadoras ni de teología. Sabía qué palabras suelen seguir a qué palabras cuando alguien escribe así.
La creatividad proviene de la petición humana; la máquina solo enlaza palabras coherentes con el registro.
Queda aún una objeción más seria, y conviene no despreciarla. Alejandro Espeso-García, de la Universidad Católica de Murcia, sostiene en un artículo de 2025 que estos sistemas no se limitan a ejecutar tareas, sino que “emulan procesos de razonamiento”. Es cierto que los modelos más recientes encadenan pasos intermedios antes de responder, y que eso les permite resolver problemas de varios movimientos y actuar con bastante autonomía.
Pero esos pasos también se aprenden. Wulff y Mata explican el procedimiento: se entrena al modelo por refuerzo, premiando las cadenas de pasos que llevan a un resultado comprobable. Lo que ocurre dentro de esas cadenas sigue siendo opaco incluso para quienes construyen los modelos, y acertar mucho no garantiza explicar nada, advierten esos mismos autores. Emular un proceso y realizarlo no es lo mismo.
Hay una consecuencia de todo esto que merece un artículo propio: un sistema que calcula lo más probable produce falsedades con la misma fluidez y el mismo aplomo con que produce verdades.
Encadenar pasos lógicos emula el razonamiento, pero no disipa la opacidad de su mecanismo interno.
Qué hacer con esto en la escuela
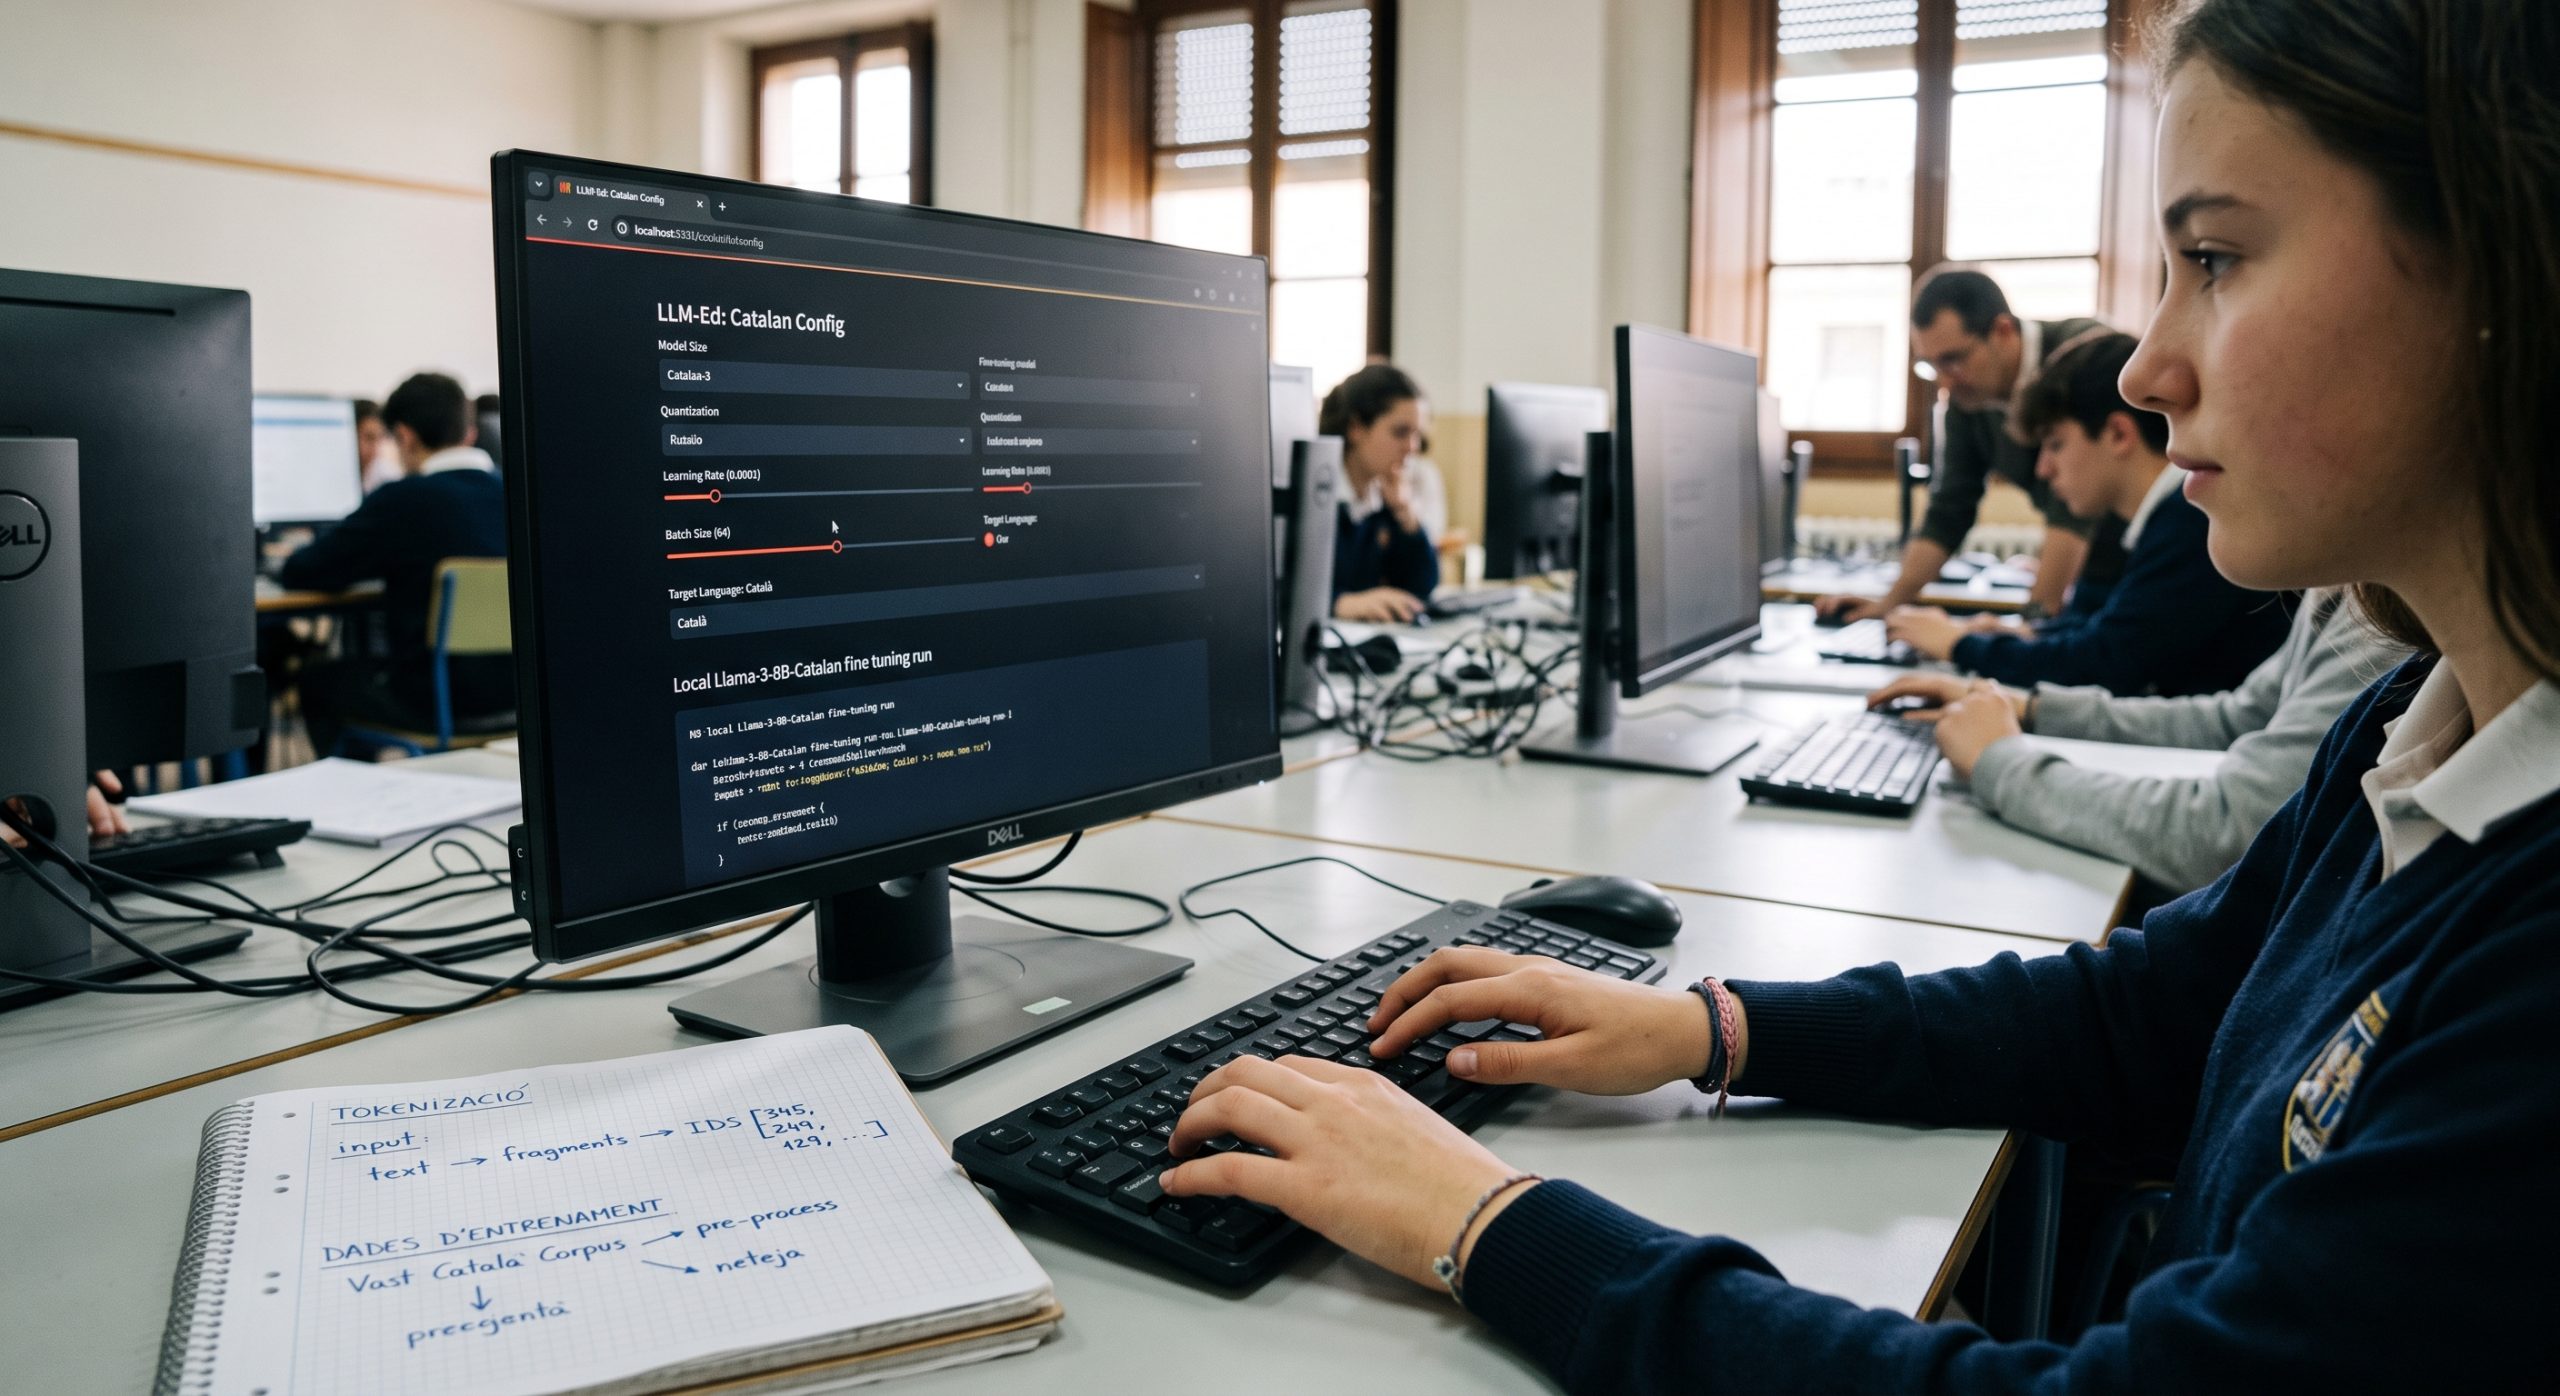
En el aula. El proyecto finlandés Generation AI ofrece una herramienta llamada Little Language Machine, un entorno en el navegador donde el alumnado entrena su propio modelo de lenguaje, un transformador real mucho más pequeño que los comerciales. Se ejecuta en local y no envía datos a servidores externos. Quien la usa ve el modelo pasar de secuencias de caracteres al azar a un texto cada vez más coherente, y puede modificar los datos de entrenamiento, el tamaño del modelo y la aleatoriedad para observar qué cambia. La herramienta está en beta abierta desde 2025 y su publicación se prevé para el otoño de 2026, de modo que conviene probarla antes de llevarla a clase.
En el aula. Repetir el experimento de la tostadora con un encargo propio, disparatado y muy específico, y pedir al alumnado que localice dónde estaba exactamente la creatividad.
Para el equipo directivo. Un guion de diez minutos, para claustro o para reunión de familias, con las tres ideas de este post: la máquina predice, el mapa no es el territorio, la fluidez convence. Con una precaución. En un estudio Delphi internacional publicado en 2026 y dirigido por Jonas Hallström, catedrático de didáctica de la tecnología en la Universidad de Linköping, el panel de expertos rechazó con claridad la idea de que aprender sobre inteligencia artificial consista sobre todo en usar aplicaciones generativas de texto como ChatGPT: esa afirmación obtuvo una media de 2,037 sobre 5. Alfabetizar no consiste únicamente en abrir cuentas y enseñar a redactar peticiones.
La alfabetización en IA requiere entender los fundamentos técnicos en lugar de aprender solo a redactar peticiones.
Para terminar
Ese mismo estudio sostiene que la comprensión técnica es “prerrequisito para ser crítico y ético” con la inteligencia artificial. Es la razón de que esta serie empiece por la máquina y no por las políticas de centro. Conviene añadir, en honor a la precisión, que el panel no llegó a consensuar que haya que abrir del todo la caja negra: esa afirmación se descartó por falta de acuerdo entre los expertos. El desacuerdo está en cuánta profundidad técnica se necesita, no en si hace falta alguna. Entender el mecanismo no es un argumento contra la tecnología. Es la condición para poder discutirla.
Para seguir pensando. Si mañana la máquina acertara siempre, ¿cambiaría algo de lo que hemos visto aquí? Y una segunda pregunta, más incómoda: de las decisiones que hemos tomado este curso sobre inteligencia artificial, ¿cuáles dependían de creer que pensaba realmente?
Comprender el funcionamiento interno de la tecnología es la condición básica para regularla y evaluarla.
Valora el post
Te puede interesar