El judici no es delega · 3 de 12
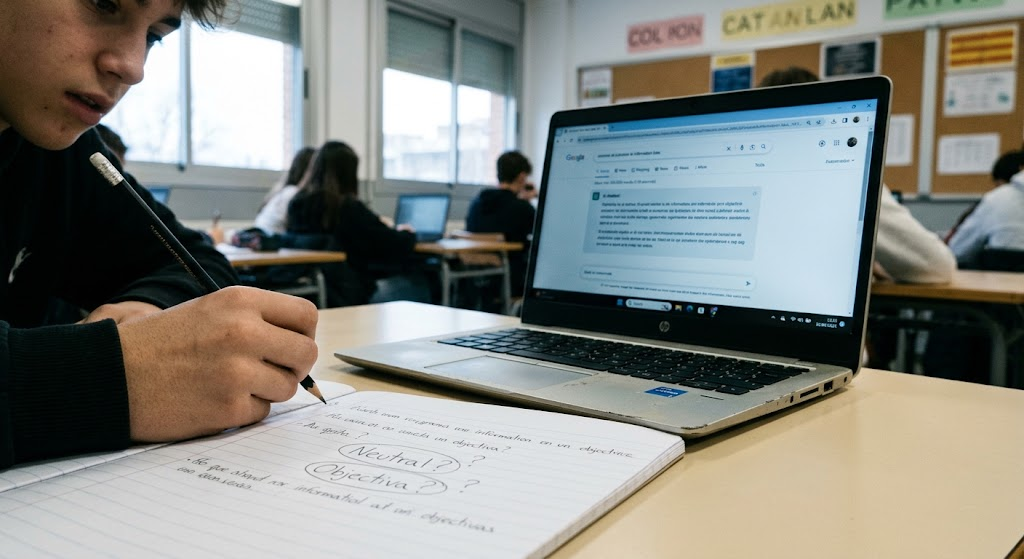
Se sol dir que la màquina, almenys, és imparcial. No té prejudicis perquè no té opinions, no té interessos perquè no cobra, i per això en més d’un claustre se la rep com l’únic participant neutral de la conversa. Ningú no va programar aquest prejudici. I hi és de totes maneres.
Aquesta és una idea raonable, i era la que tenia l’alumnat de 1r de Batxillerat que va participar en l’experiència documentada per Miquel Àngel Fuentes Arjona, docent de secundària en un centre públic de Catalunya i formador en competència digital docent, recollida a l’Informe ODITE 2026. En començar, preguntats pels biaixos, diversos van respondre que la IA «era neutral perquè és una màquina», algun que era totalment objectiva, i dos van reconèixer que no sabien què significava la paraula biaix. En acabar la seqüència parlaven de discriminació, d’estereotips i de l’origen de les dades i de les decisions de qui les dissenya (4).
Algú va triar què hi entrava
Convé tornar un moment al mecanisme de l’article anterior i donar-hi una volta més. Un model de llenguatge ordena probabilitats sobre la paraula següent a partir d’un conjunt enorme de textos. Però aquest conjunt no va caure del cel. El Marc d’Alfabetització en IA que l’OCDE i la Comissió Europea van publicar el 2026 ho formula amb una precisió que mereix llegir-se a poc a poc: els sistemes s’entrenen per identificar patrons entre elements de dades que els éssers humans han seleccionat, categoritzat i prioritzat (1).
Tres verbs, tres decisions. Seleccionar és decidir què hi entra i què es queda fora. Categoritzar és decidir quines coses compten com la mateixa cosa. Prioritzar és decidir què pesa més. Cap de les tres no és la decisió de discriminar ningú, i el resultat discrimina igualment. Per això el mateix marc sosté que «en els sistemes d’IA existeix un biaix intrínsec», que pot a més reflectir biaixos socials presents en les dades d’entrenament o en el disseny dels algorismes, i que les persones poden agreujar-los o mitigar-los, de manera accidental o deliberada, durant el disseny, el desenvolupament, les proves i l’ús (1).
El marc d’alfabetització en IA que Kelly Mills i els seus col·legues van publicar el 2024 a Digital Promise, organització nord-americana sense ànim de lucre dedicada a l’equitat educativa, recull exemples que el mateix alumnat detecta i que van força més enllà del tòpic. Sistemes de reconeixement facial que encerten més amb rostres blancs que amb els altres. Sistemes que no reconeixen les veus infantils. Assistents de veu amb timbre femení per defecte, que reforcen una norma de gènere que ningú no va arribar a escriure enlloc (2).
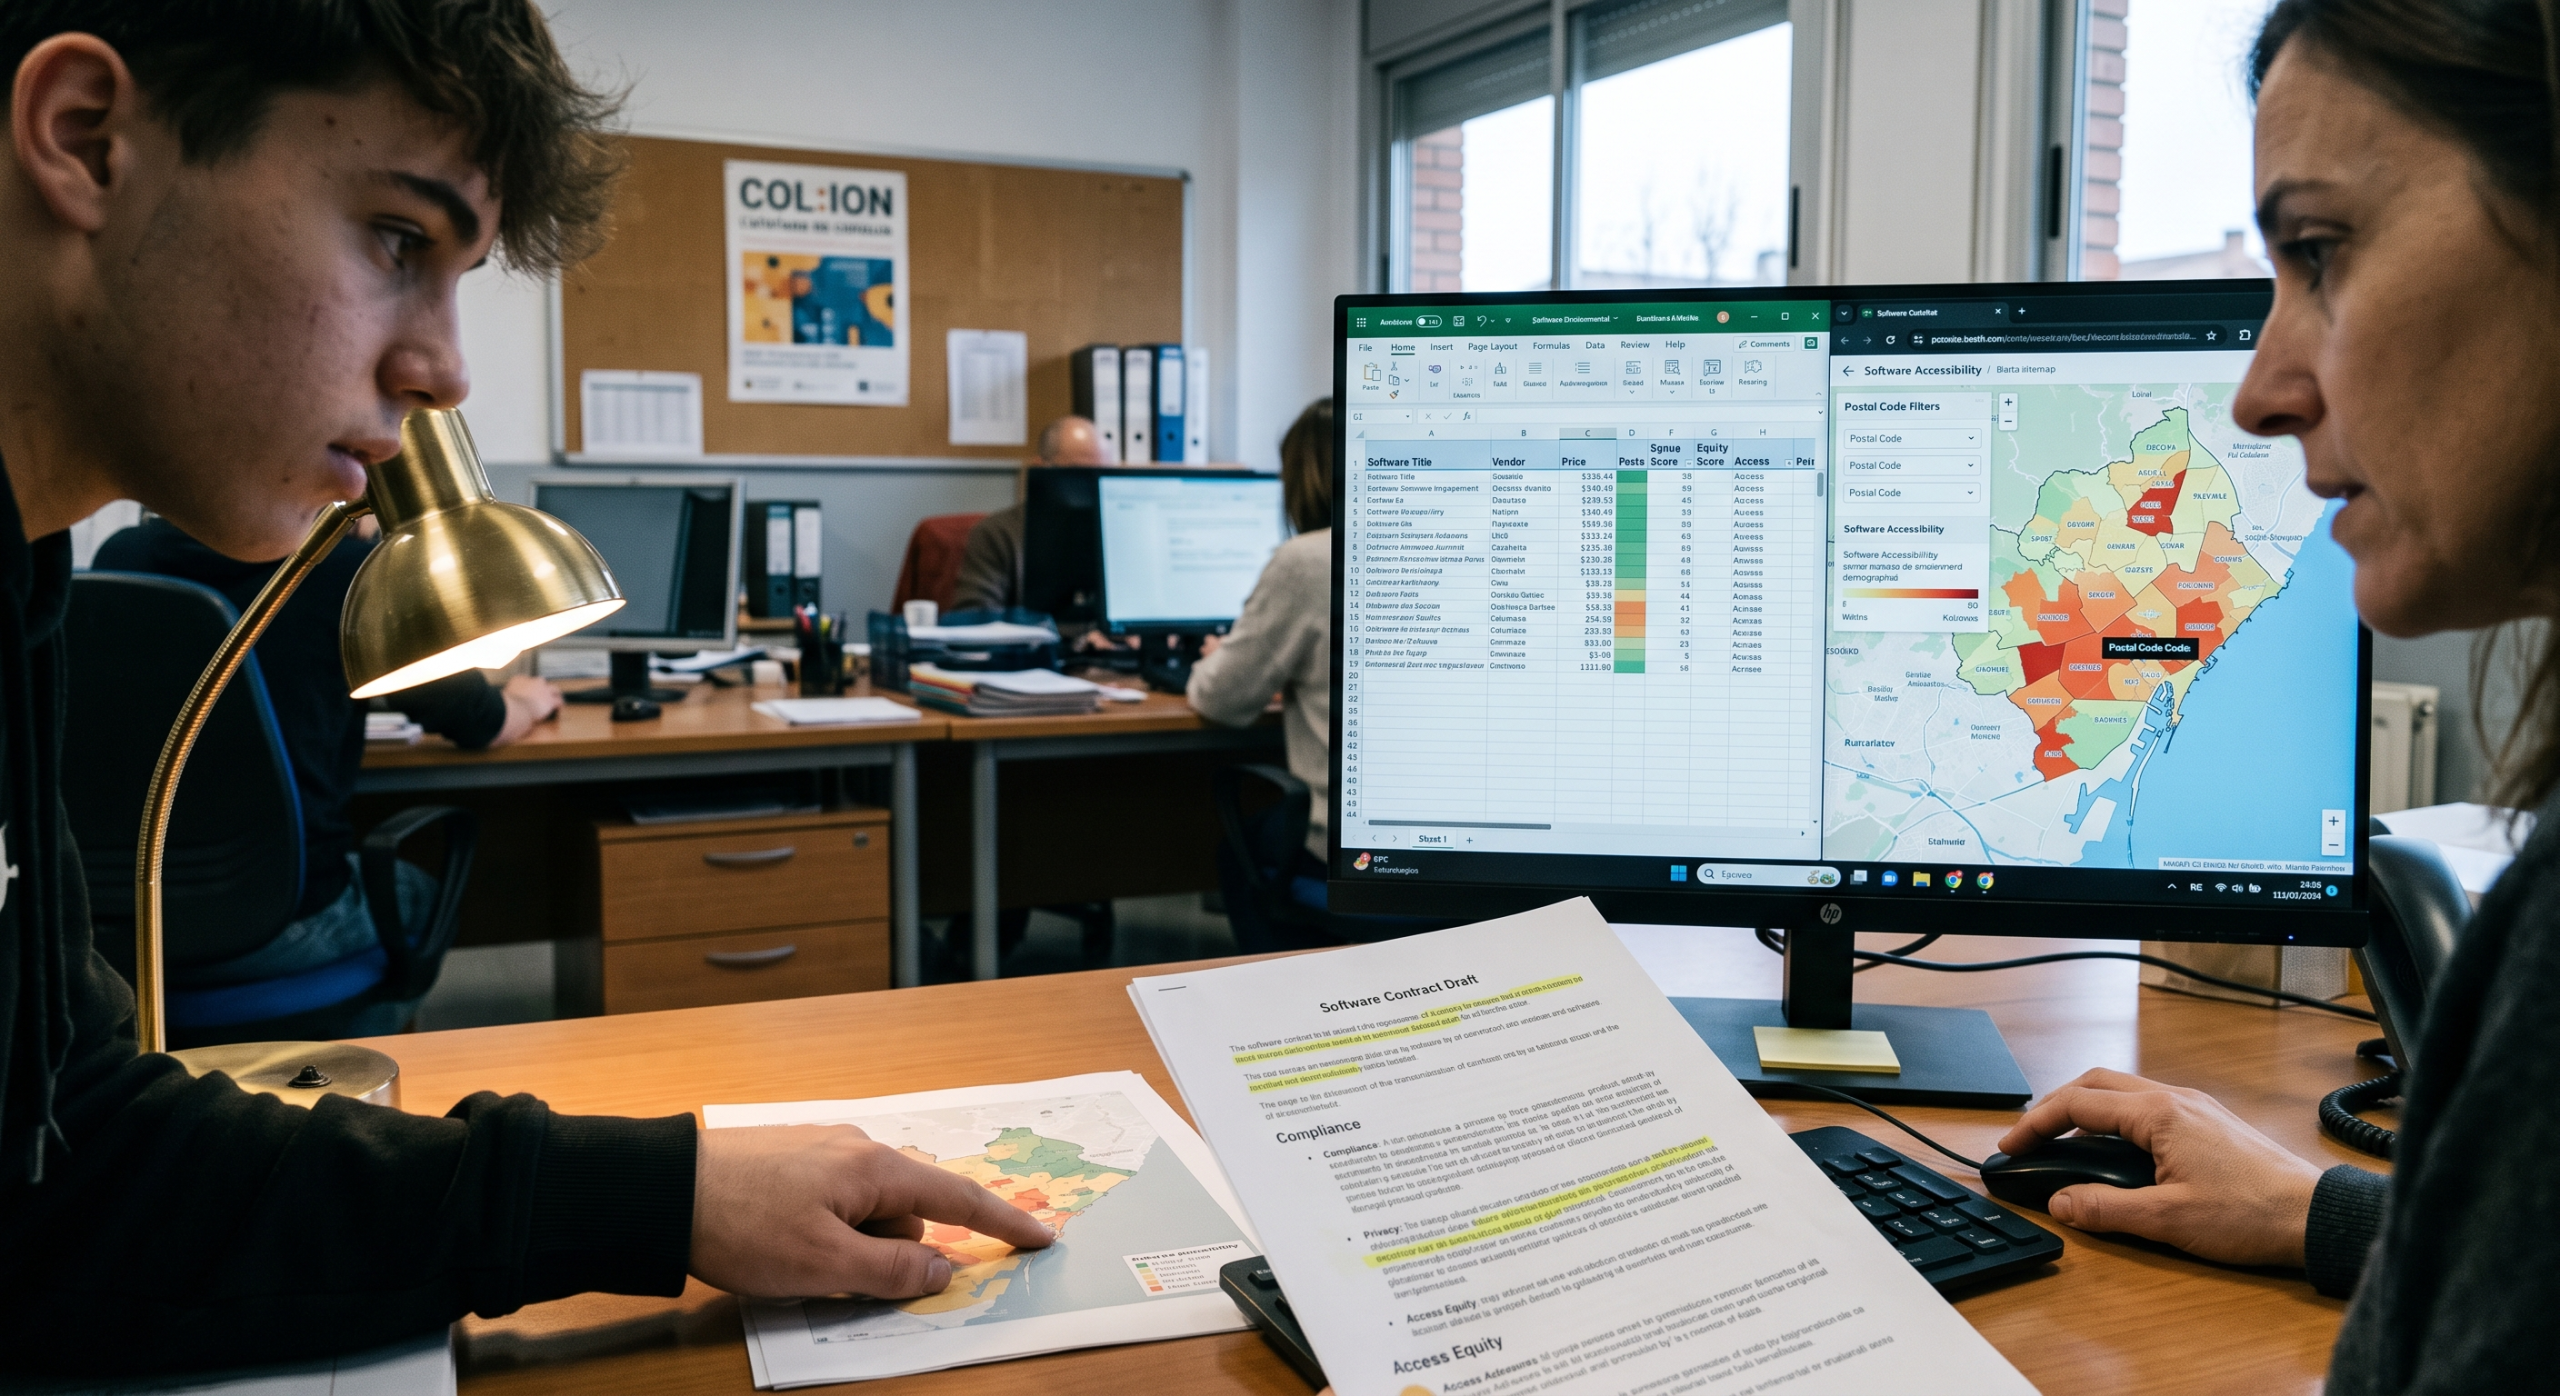
Hi ha un mecanisme més fi, i és el que convé entendre abans de signar un contracte amb un proveïdor. Un model que reparteix oportunitats pot no fer servir la raça, ni la religió, ni el gènere, ni l’edat, i discriminar exactament igual a partir del codi postal i del nivell d’estudis de la família, que funcionen com a substituts de les variables prohibides (2).
Sembla que la solució passaria per recollir més dades, oi?, doncs resulta que no. El mateix text adverteix que els intents de corregir la infrarepresentació recollint més informació sobre comunitats ja vulnerables han causat danys afegits, i plantegen problemes seriosos de consentiment i de vigilància (2).
Seleccionar, categoritzar i prioritzar dades d’entrenament introdueix biaixos socials sense necessitat de programar-los expressament.
La llengua en què es va pensar
El desequilibri no és només de categories. També és geogràfic i lingüístic.
Jasper Roe, professor de la Facultat d’Educació de la Universitat de Durham, amb Leon Furze i Mike Perkins, sosté en un article publicat el 2026 a Pedagogies: An International Journal que l’absència de sistemes produïts localment porta a dependre de models de grans corporacions entrenats sobre bases de dades centrades a Occident i en llengua anglesa. Els autors recullen per descriure’ls la idea de les «màquines de cultura», sistemes que graviten cap a les generalitats culturals i lingüístiques dominants (3). Tot i que convé dir de quin tipus de treball es tracta, perquè marca fins on arriba: és una anàlisi conceptual, sense dades pròpies, que proposa un marc per pensar. No és un estudi empíric.
Traduït a una aula, l’efecte es torna recognoscible. Carles Sierra, professor d’investigació del CSIC, director de l’Institut d’Investigació en Intel·ligència Artificial i expresident de l’Associació Europea d’IA, ho il·lustra a l’Informe ODITE 2026 amb un cas que qualsevol docent pot imaginar: un sistema que reconegués únicament accents castellans podria discriminar els alumnes amb altres pronunciacions. I n’afegeix un que dona encara més a pensar en un centre educatiu, el del biaix de confirmació: un sistema que privilegia els patrons previsibles ja presents en les dades penalitza o invisibilitza les respostes originals, creatives o minoritàries de l’alumnat, confirmant només allò que ja figurava en el registre (4).
Queda una segona capa, força menys comentada. El biaix no procedeix únicament del que va entrar, sinó també del que s’ajusta després. Roe, Furze i Perkins recorden que les distorsions es poden introduir no des de les dades d’entrenament sinó des dels mateixos desenvolupadors, que supervisen i corregeixen la sortida del model un cop entrenat (3). El Marc d’Alfabetització en IA ho confirma des d’un altre angle: part de l’entrenament pot incloure aprenentatge per reforç, en què el sistema millora per assaig i error guiat per valoracions i recompenses (1). Algú decideix quina resposta mereix recompensa.
El corpus és el món que va cabre a les dades. L’ajust és la mà que després retalla les vores.
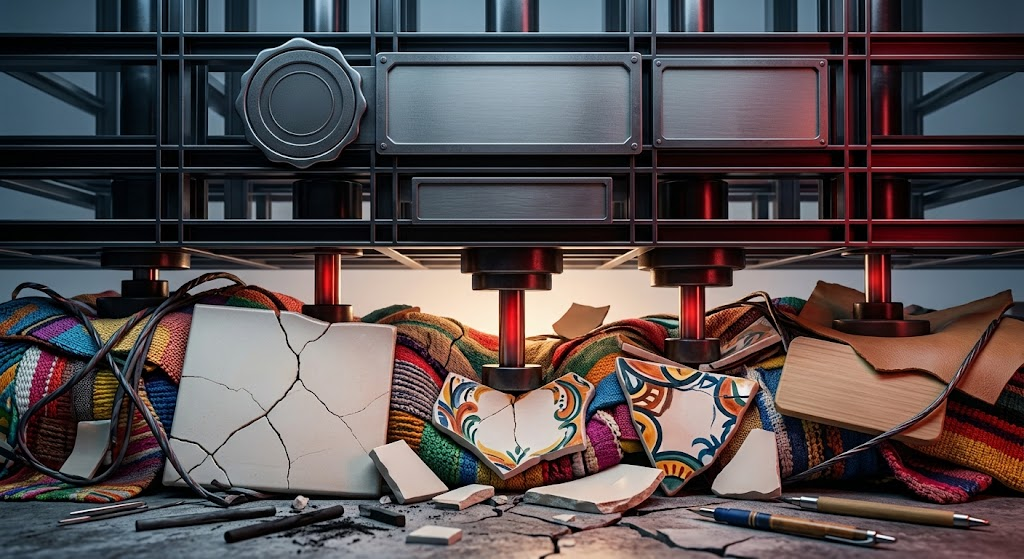
Els models basats en corpus dominants penalitzen les variants lingüístiques locals i la creativitat minoritària.
Dos alumnes, la mateixa eina
Arribats a aquest punt, la pregunta deixa de ser tècnica i passa a ser nostra. Si tots els alumnes del centre tenen la mateixa eina oberta a la mateixa pantalla, estan en la mateixa situació?
Roe, Furze i Perkins responen que no, i l’argument és el més útil de tot el seu article. Distingeixen entre l’accés material i l’accés epistèmic. El primer consisteix a tenir el dispositiu, la connexió i la llicència. El segon consisteix a conèixer els supòsits culturals incorporats en l’eina, saber que hi són i poder interrogar-los. Qui no disposa del segon queda, en els termes de Paulo Freire que els autors recuperen, com a recipient passiu d’un coneixement que no està en condicions de transformar (3).
I és que l’escletxa no separa només països, separa pupitres. Els mateixos autors assenyalen que qui no pot pagar els models de subscripció recorre a les eines gratuïtes, de qualitat potencialment menor (3). En una aula ordinària això significa que dos alumnes que lliuren el mateix treball no han fet servir la mateixa màquina, ni han tingut la mateixa capacitat de discutir el que la màquina els va dir.
D’aquí que el consens internacional apunti on apunta. L’estudi Delphi coordinat per Jonas Hallström, de la Universitat de Linköping, va tancar tres rondes de consulta amb acord en només vuit de vint-i-tres enunciats. Dos d’aquests vuit fan al cas: que l’alumnat necessita aprendre sobre les limitacions d’aquests sistemes, per exemple les degudes al biaix, i que el pensament crític és l’habilitat més important per examinar biaixos, dades esbiaixades i deepfakes (5).
Interessa igual de molt allò en què no hi va haver acord. L’enunciat que proposava que l’alumnat necessita obrir la caixa negra de la IA no va assolir consens (5). Ningú no demana que una noia de quinze anys auditi un model. El que es demana és que sàpiga que a dins hi ha decisions humanes i que pugui preguntar-ne, perquè, segons recordava un dels panelistes, sense una comprensió bàsica de com es produeix el biaix el sistema continua sent per a l’alumnat una caixa negra màgica davant la qual no hi ha lloc per a cap agència (5).
Tenir el dispositiu no garanteix comprendre ni discutir els supòsits culturals de la màquina.
Què fer amb això
A l’aula, a primària. Olga Armengol Pastallé, mestra d’entorn digital a l’Escola Sant Nicolau de Sabadell, documenta a l’Informe ODITE 2026 el projecte «Detectem insults amb la IA?», desenvolupat amb 52 alumnes de 5è de Primària i dos docents en codocència. L’alumnat va construir primer un mural amb paraules i insults racistes, masclistes i homòfobs, recollits a classe i a casa amb ajuda de les famílies, i hi va entrenar després un classificador a Learning ML, programant la interfície a Scratch 3.0 per observar els percentatges d’encert. Un alumne ho va resumir millor que qualsevol definició: la IA aprèn com nosaltres, «si li donem dades dolentes, també s’equivoca» (4). L’avaluació va ser formativa, amb rúbriques i diari d’aprenentatge, no un disseny controlat.
A l’aula, a secundària. El projecte finlandès Generation AI, finançat pel Consell d’Investigació de Finlàndia i premiat el 2026 amb el Premi Europeu de Competències Digitals, ofereix de manera gratuïta l’aplicació Teachable Machine, que no és l’eina homònima de Google. Funciona al navegador, en local, sense recollir dades personals, i permet entrenar un classificador d’imatges amb els exemples que el mateix grup triï. L’activitat consisteix a entrenar-lo amb un conjunt deliberadament desequilibrat i comprovar a qui reconeix pitjor. Així, segons formula el mateix projecte, la IA es presenta com un sistema dissenyat i modelat per persones, i no com una caixa negra opaca (6).
Per a l’equip directiu. Dos criteris abans d’adoptar qualsevol eina. El primer l’enuncia Digital Promise sense embuts: els sistemes el funcionament intern dels quals no es pot examinar no s’haurien d’emprar en decisions d’alt impacte, i val la pena preguntar-se quines ho són en un centre (2). El segon és la pregunta que gairebé mai no es fa al proveïdor: funciona igual de bé amb l’alumnat que tenim nosaltres (4)?
Per al claustre. La revisió sistemàtica d’Iliana Guaranda-Arias i els seus col·legues de la Universitat Estatal de Milagro, a l’Equador, situa la identificació de biaixos entre els continguts que hauria d’incloure la formació del professorat, al costat de l’anàlisi de casos i la verificació de fonts, amb l’advertència que el predomini de dissenys descriptius impedeix establir causalitat (7).
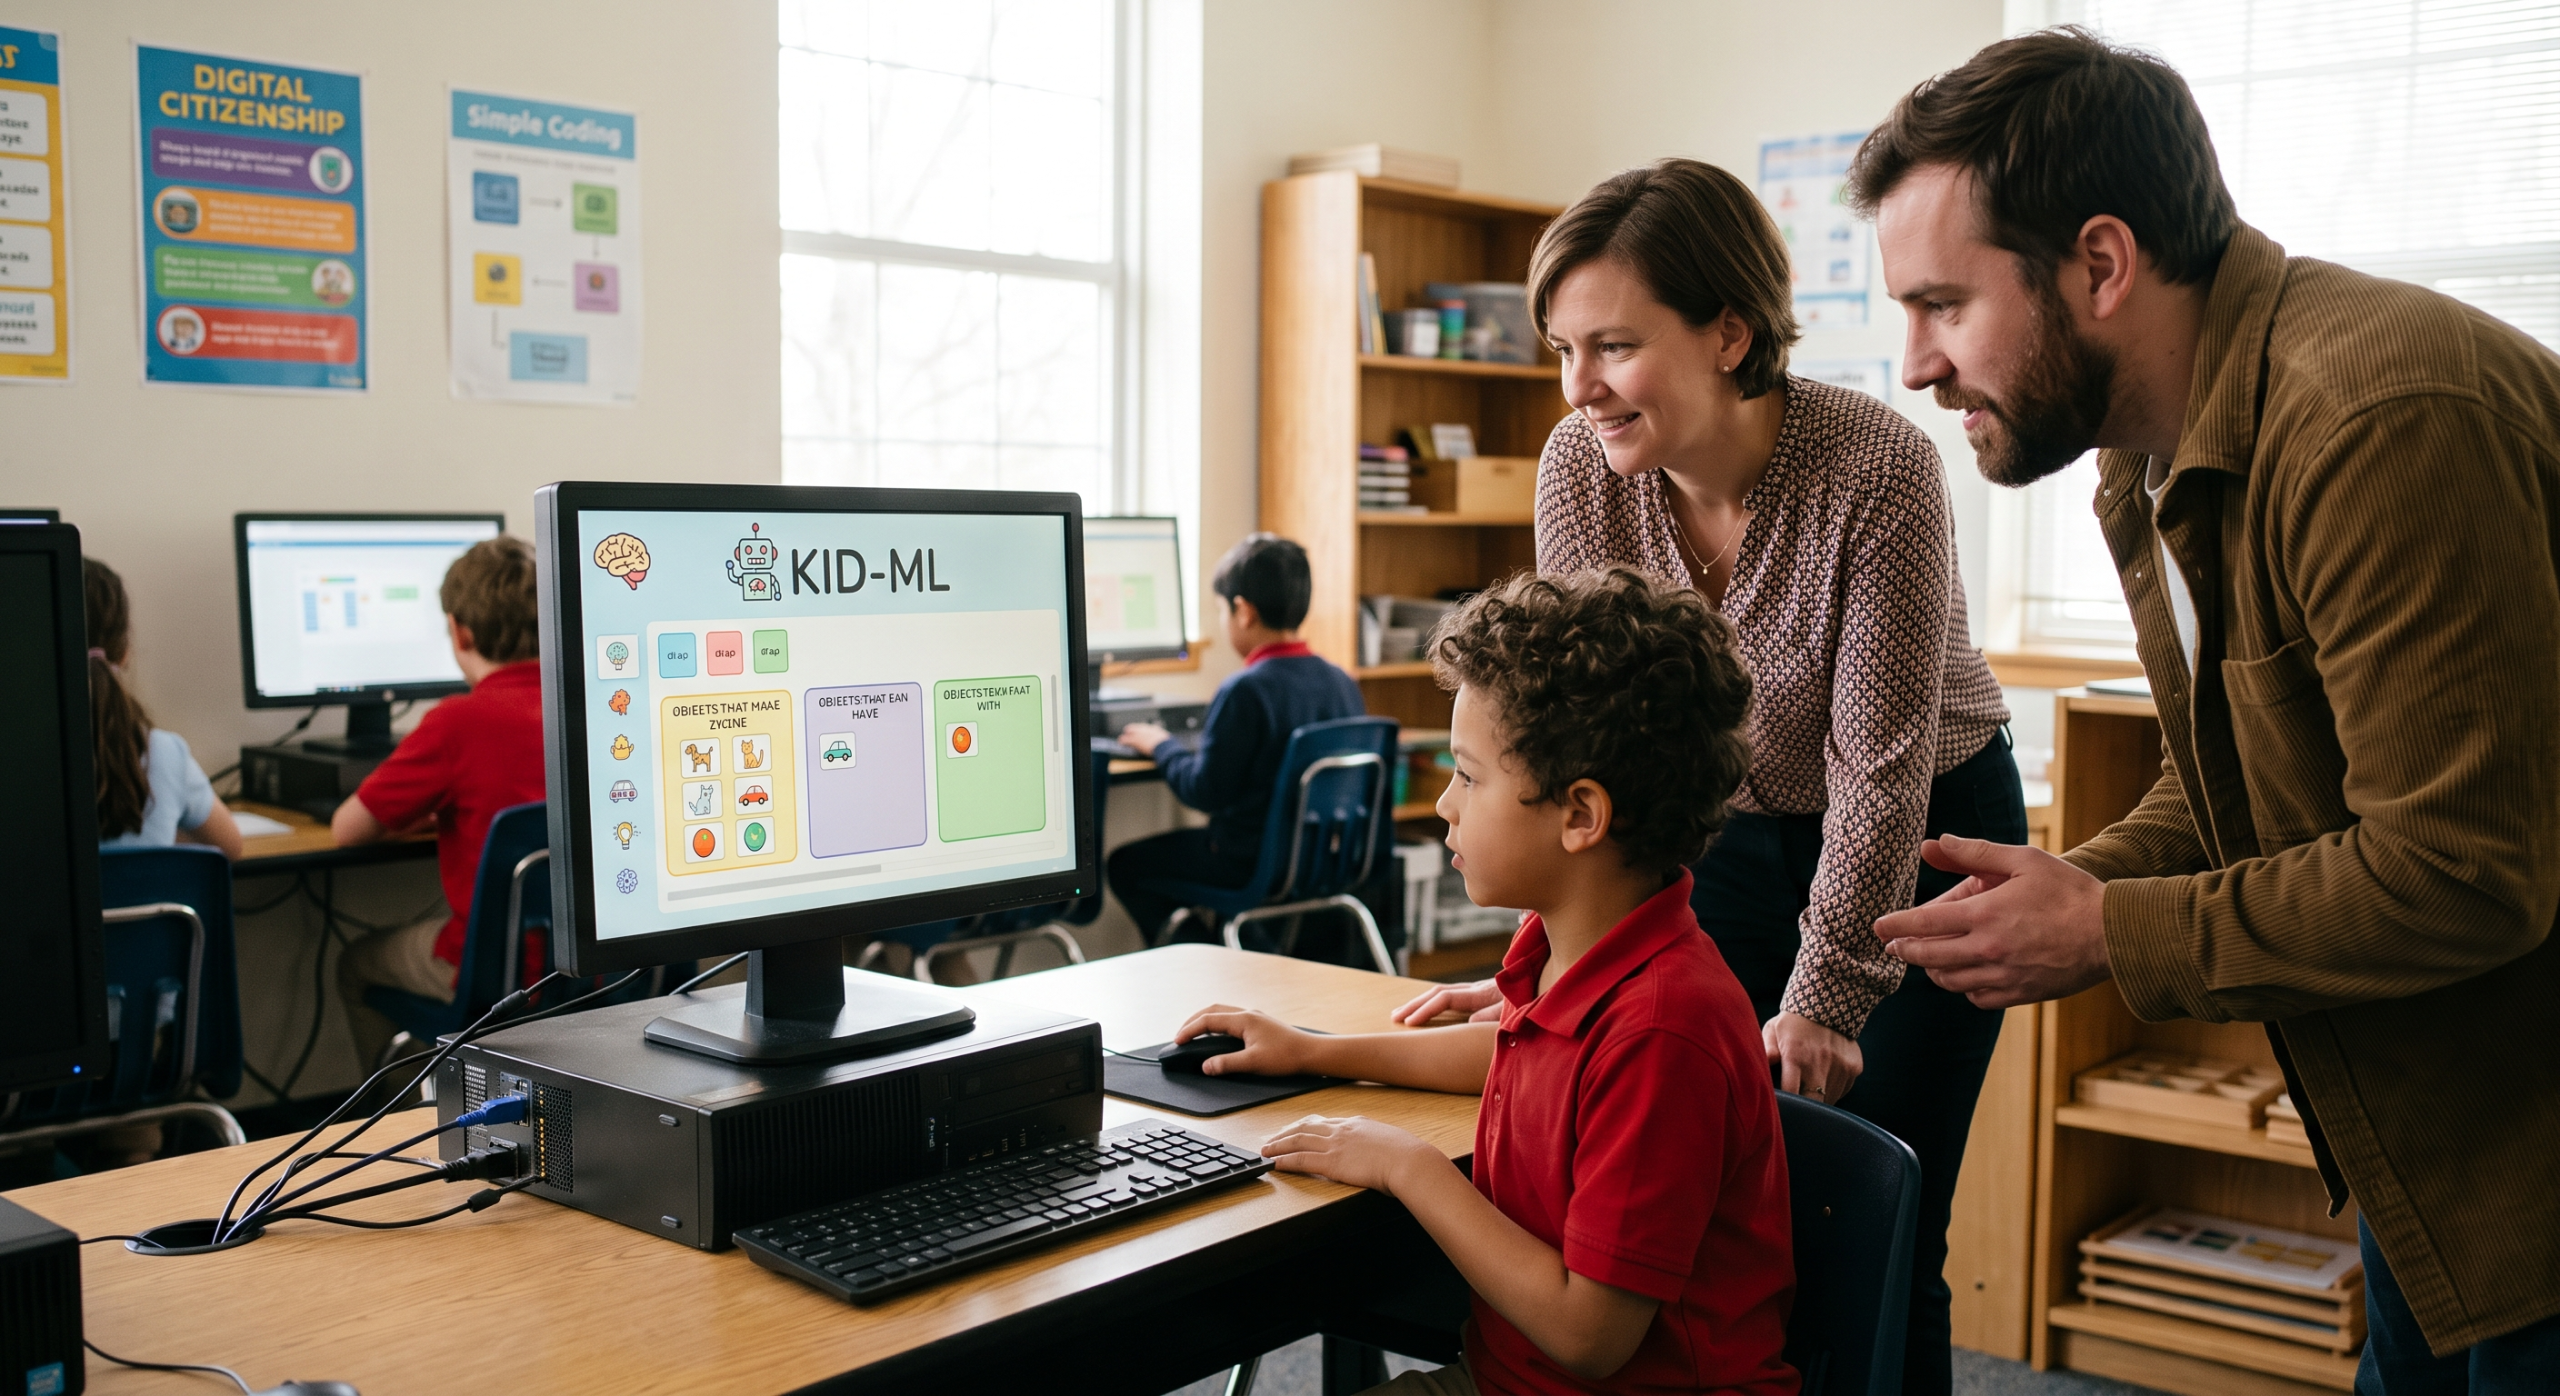
Entrenar models amb dades pròpies a l’escola permet comprovar com s’originen els errors algorísmics.
Per acabar
El biaix de la IA no és una fallada moral de la màquina ni la maldat de qui la va programar. És el resultat acumulat de decisions raonables preses per separat: quines dades es recullen, com s’agrupen i què es premia en ajustar el model. Per això no es corregeix exigint bones intencions. Es corregeix ensenyant a preguntar què falta, qui no apareix i en quina llengua es va pensar això. És una competència, i les competències s’ensenyen.
Per continuar pensant. Dels nostres alumnes, quins estan avui en condicions de notar el que l’eina ha deixat fora, i quins no? I si aquesta diferència segueix la línia del que cada un té a casa, quina part pot compensar el centre aquest curs?
El biaix es corregeix ensenyant a preguntar qui no apareix i quines dades falten.
Glossari
- Biaix algorísmic. Distorsió sistemàtica en els resultats d’un sistema informàtic que afavoreix o perjudica determinats grups, sense que ningú no ho hagi disposat de manera explícita.
- Dades d’entrenament. Conjunt de textos, imatges o registres a partir dels quals un sistema aprèn patrons. El que no hi és, per al sistema no existeix.
- Representativitat. Grau en què les dades d’entrenament reflecteixen la diversitat real de les persones i situacions sobre les quals el sistema ha d’operar.
- Variable substituta. Dada que no anomena una característica protegida però funciona al seu lloc. El codi postal pot substituir l’origen social sense esmentar-lo.
- Caixa negra. Sistema el funcionament intern del qual no es pot examinar des de fora, de manera que es coneixen les entrades i les sortides, però no el camí entre totes dues.
- Accés epistèmic. Enfront de l’accés material, que consisteix a disposar de l’eina, és la possibilitat de comprendre els supòsits que l’eina incorpora i sotmetre’ls a discussió.
Referències
- OCDE i Comissió Europea (2026). Cómo preparar a los alumnos para la era de la IA. Marco de Alfabetización en IA.
- Mills, K. i altres (2024). AI Literacy: A Framework to Understand, Evaluate, and Use Emerging Technology. Digital Promise.
- Roe, J., Furze, L. i Perkins, M. (2026). Digital plastic: a metaphorical framework for Critical AI Literacy in the multiliteracies era. Pedagogies: An International Journal, 21(2), 185-199.
- Informe ODITE 2026. Claves para una nueva educación. Espiral, Educación y Tecnología. Capítols de Carles Sierra, Miquel Àngel Fuentes Arjona i Olga Armengol Pastallé.
- Hallström, J., Mannila, L., Nordlöf, C., Heintz, F., Sperling, K. i Stenliden, L. (2026). AI literacy for K–12 education: an international Delphi study. Interactive Learning Environments.
- Generation AI (2023-2026). Projecte d’investigació finançat pel Consell d’Investigació de Finlàndia. Fitxa de l’aplicació Teachable Machine. https://www.gen-ai.fi/en/tools/tm
- Guaranda-Arias, I. i altres (2026). Alfabetización ética en inteligencia artificial y pensamiento crítico docente: revisión sistemática. Innova Science Journal, 4(3).
Valora el post
Et pot interessar