El juicio no se delega · 3 de 12
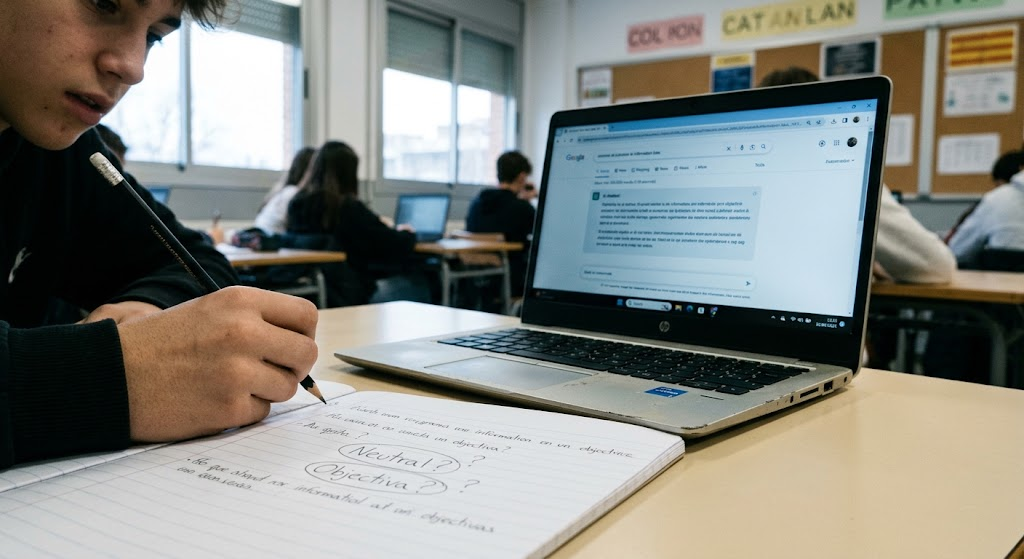
Suele decirse que la máquina, al menos, es imparcial. No tiene prejuicios porque no tiene opiniones, no tiene intereses porque no cobra, y por eso en más de un claustro se la recibe como el único participante neutral de la conversación. Nadie programó ese prejuicio. Y está ahí de todos modos.
Esta es una idea razonable, y era la que tenía el alumnado de 1.º de Bachillerato que participó en la experiencia documentada por Miquel Àngel Fuentes Arjona, docente de secundaria en un centro público de Cataluña y formador en competencia digital docente, recogida en el Informe ODITE 2026. Al empezar, preguntados por los sesgos, varios respondieron que la IA «era neutral porque es una máquina», alguno que era totalmente objetiva, y dos reconocieron que no sabían qué significaba la palabra sesgo. Al terminar la secuencia hablaban de discriminación, de estereotipos y del origen de los datos y de las decisiones de quien los diseña (4).
Alguien eligió qué entraba
Conviene volver un momento al mecanismo del artículo anterior y darle una vuelta más. Un modelo de lenguaje ordena probabilidades sobre la palabra siguiente a partir de un conjunto enorme de textos. Pero ese conjunto no cayó del cielo. El Marco de Alfabetización en IA que la OCDE y la Comisión Europea publicó en 2026 lo formula con una precisión que merece leerse despacio: los sistemas se entrenan para identificar patrones entre elementos de datos que los seres humanos han seleccionado, categorizado y priorizado (1).
Tres verbos, tres decisiones. Seleccionar es decidir qué entra y qué se queda fuera. Categorizar es decidir qué cosas cuentan como la misma cosa. Priorizar es decidir qué pesa más. Ninguna de las tres es la decisión de discriminar a nadie, y el resultado discrimina igual. Por eso el mismo marco sostiene que «en los sistemas de IA existe un sesgo intrínseco», que puede además reflejar sesgos sociales presentes en los datos de entrenamiento o en el diseño de los algoritmos, y que las personas pueden agravarlos o mitigarlos, de forma accidental o deliberada, durante el diseño, el desarrollo, las pruebas y el uso (1).
El marco de alfabetización en IA que Kelly Mills y sus colegas publicaron en 2024 en Digital Promise, organización estadounidense sin ánimo de lucro dedicada a la equidad educativa, recoge ejemplos que el propio alumnado detecta y que van bastante más allá del tópico. Sistemas de reconocimiento facial que aciertan más con rostros blancos que con los demás. Sistemas que no reconocen las voces infantiles. Asistentes de voz con timbre femenino por defecto, que refuerzan una norma de género que nadie llegó a escribir en ninguna parte (2).
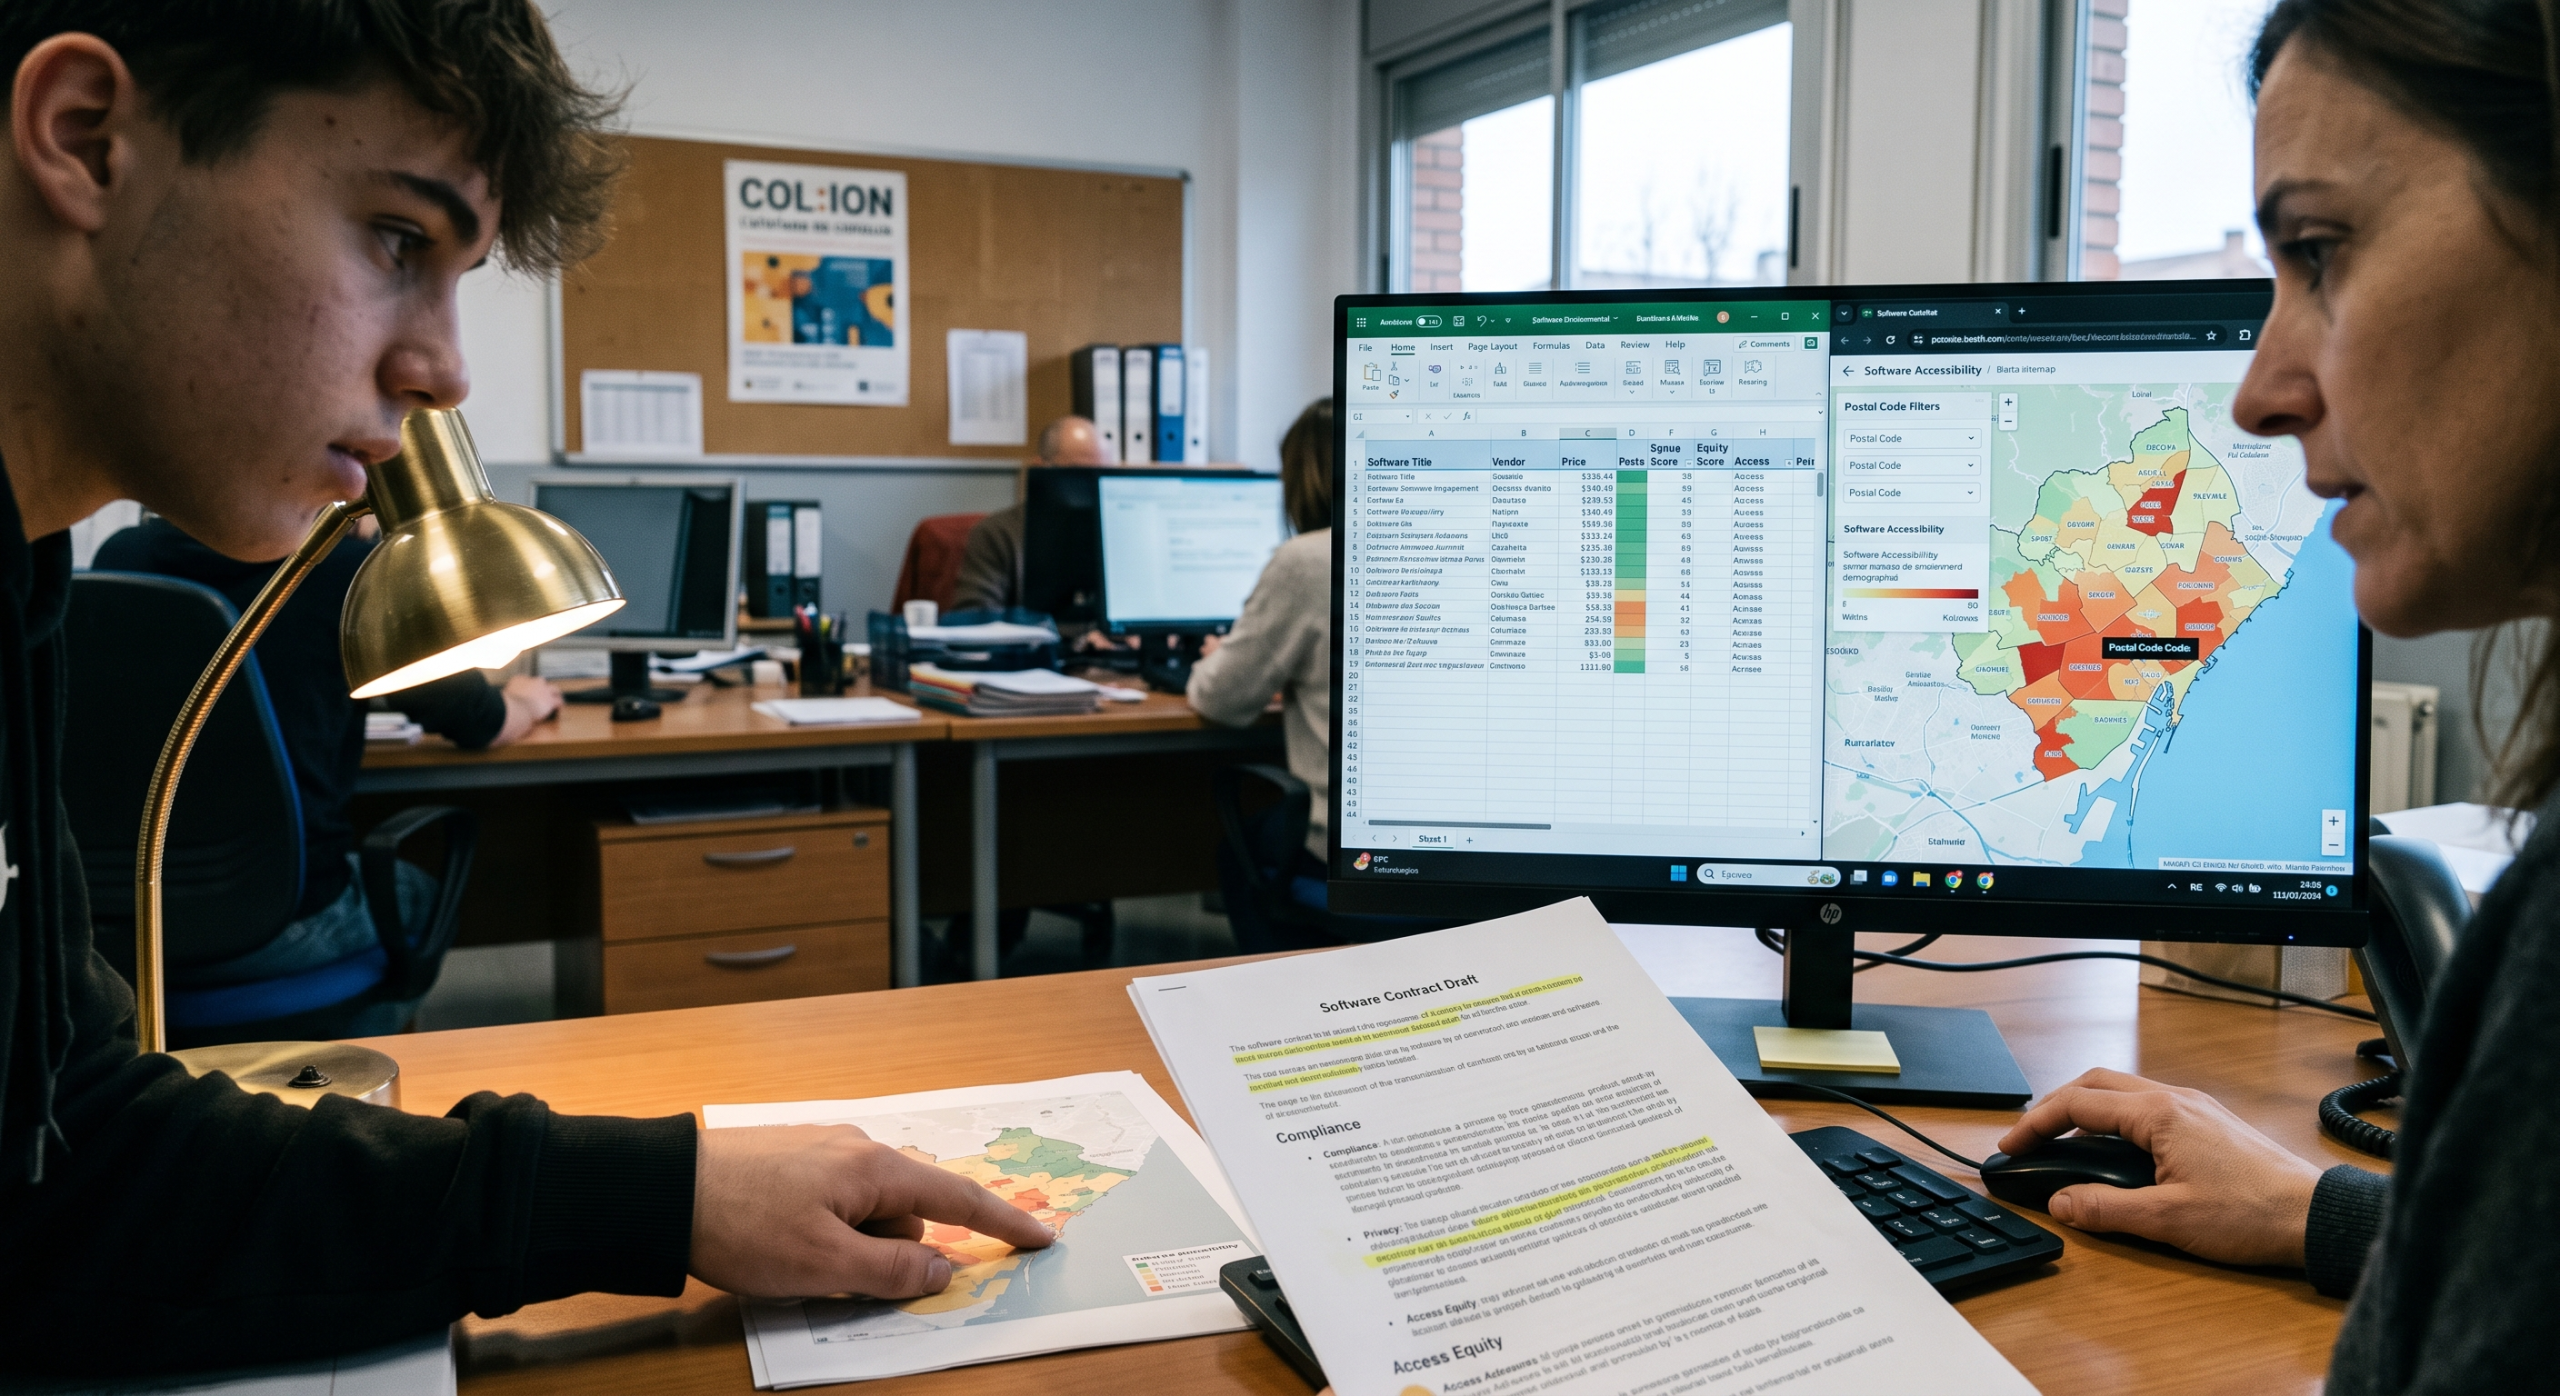
Hay un mecanismo más fino, y es el que conviene entender antes de firmar un contrato con un proveedor. Un modelo que reparte oportunidades puede no usar la raza, ni la religión, ni el género, ni la edad, y discriminar exactamente igual a partir del código postal y del nivel de estudios de la familia, que funcionan como sustitutos de las variables prohibidas (2).
Parece que la solución pasaría por recoger más datos, ¿verdad?, pues resulta que no. El mismo texto advierte de que los intentos de corregir la infrarrepresentación recogiendo más información sobre comunidades ya vulnerables han causado daños añadidos, y plantean problemas serios de consentimiento y de vigilancia (2).
Seleccionar, categorizar y priorizar datos de entrenamiento introduce sesgos sociales sin necesidad de programarlos expresamente.
La lengua en la que se pensó
El desequilibrio no es solo de categorías. También es geográfico y lingüístico.
Jasper Roe, profesor de la Facultad de Educación de la Universidad de Durham, con Leon Furze y Mike Perkins, sostiene en un artículo publicado en 2026 en Pedagogies: An International Journal que la ausencia de sistemas producidos localmente lleva a depender de modelos de grandes corporaciones entrenados sobre bases de datos centradas en Occidente y en lengua inglesa. Los autores recogen para describirlos la idea de las «máquinas de cultura», sistemas que gravitan hacia las generalidades culturales y lingüísticas dominantes (3). Aunque conviene decir de qué tipo de trabajo se trata, porque marca hasta dónde llega: es un análisis conceptual, sin datos propios, que propone un marco para pensar. No es un estudio empírico.
Traducido a un aula, el efecto se vuelve reconocible. Carles Sierra, profesor de investigación del CSIC, director del Instituto de Investigación en Inteligencia Artificial y expresidente de la Asociación Europea de IA, lo ilustra en el Informe ODITE 2026 con un caso que cualquier docente puede imaginar: un sistema que reconociera únicamente acentos castellanos podría discriminar a los alumnos con otras pronunciaciones. Y añade uno que da todavía más que pensar en un centro educativo, el del sesgo de confirmación: un sistema que privilegia los patrones previsibles ya presentes en los datos penaliza o invisibiliza las respuestas originales, creativas o minoritarias del alumnado, confirmando solo aquello que ya figuraba en el registro (4).
Queda una segunda capa, bastante menos comentada. El sesgo no procede únicamente de lo que entró, sino también de lo que se ajusta después. Roe, Furze y Perkins recuerdan que las distorsiones pueden introducirse no desde los datos de entrenamiento sino desde los propios desarrolladores, que supervisan y corrigen la salida del modelo una vez entrenado (3). El Marco de Alfabetización en IA lo confirma desde otro ángulo: parte del entrenamiento puede incluir aprendizaje por refuerzo, en el que el sistema mejora por ensayo y error guiado por valoraciones y recompensas (1). Alguien decide qué respuesta merece recompensa.
El corpus es el mundo que cupo en los datos. El ajuste es la mano que después recorta los bordes.
Los modelos basados en corpus dominantes penalizan las variantes lingüísticas locales y la creatividad minoritaria.
Dos alumnos, la misma herramienta
Llegados a este punto, la pregunta deja de ser técnica y pasa a ser nuestra. Si todos los alumnos del centro tienen la misma herramienta abierta en la misma pantalla, ¿están en la misma situación?
Roe, Furze y Perkins responden que no, y el argumento es el más útil de todo su artículo. Distinguen entre el acceso material y el acceso epistémico. El primero consiste en tener el dispositivo, la conexión y la licencia. El segundo consiste en conocer los supuestos culturales incorporados en la herramienta, saber que están ahí y poder interrogarlos. Quien no dispone del segundo queda, en los términos de Paulo Freire que los autores recuperan, como recipiente pasivo de un conocimiento que no está en condiciones de transformar (3).
Y es que la brecha no separa solo países, separa pupitres. Los mismos autores señalan que quien no puede pagar los modelos de suscripción recurre a las herramientas gratuitas, de calidad potencialmente menor (3). En un aula ordinaria eso significa que dos alumnos que entregan el mismo trabajo no han usado la misma máquina, ni han tenido la misma capacidad de discutir lo que la máquina les dijo.
De ahí que el consenso internacional apunte donde apunta. El estudio Delphi coordinado por Jonas Hallström, de la Universidad de Linköping, cerró tres rondas de consulta con acuerdo en solo ocho de veintitrés enunciados. Dos de esos ocho vienen al caso: que el alumnado necesita aprender sobre las limitaciones de estos sistemas, por ejemplo las debidas al sesgo, y que el pensamiento crítico es la habilidad más importante para examinar sesgos, datos sesgados y deepfakes (5).
Interesa igual de mucho aquello en lo que no hubo acuerdo. El enunciado que proponía que el alumnado necesita abrir la caja negra de la IA no alcanzó consenso (5). Nadie pide que una chica de quince años audite un modelo. Lo que se pide es que sepa que dentro hay decisiones humanas y que pueda preguntar por ellas, porque, según recordaba uno de los panelistas, sin una comprensión básica de cómo se produce el sesgo el sistema sigue siendo para el alumnado una caja negra mágica ante la que no cabe ninguna agencia (5).
Tener el dispositivo no garantiza comprender ni discutir los supuestos culturales de la máquina.
Qué hacer con esto
En el aula, en primaria. Olga Armengol Pastallé, maestra de entorno digital en la Escola Sant Nicolau de Sabadell, documenta en el Informe ODITE 2026 el proyecto «¿Detectamos insultos con la IA?», desarrollado con 52 alumnos de 5.º de Primaria y dos docentes en codocencia. El alumnado construyó primero un mural con palabras e insultos racistas, machistas y homófobos, recogidos en clase y en casa con ayuda de las familias, y entrenó después con ellos un clasificador en Learning ML, programando la interfaz en Scratch 3.0 para observar los porcentajes de acierto. Un alumno lo resumió mejor que cualquier definición: la IA aprende como nosotros, «si le damos datos malos, también se equivoca» (4). La evaluación fue formativa, con rúbricas y diario de aprendizaje, no un diseño controlado.
En el aula, en secundaria. El proyecto finlandés Generation AI, financiado por el Consejo de Investigación de Finlandia y premiado en 2026 con el Premio Europeo de Competencias Digitales, ofrece de forma gratuita la aplicación Teachable Machine, que no es la herramienta homónima de Google. Funciona en el navegador, en local, sin recoger datos personales, y permite entrenar un clasificador de imágenes con los ejemplos que el propio grupo elija. La actividad consiste en entrenarlo con un conjunto deliberadamente desequilibrado y comprobar a quién reconoce peor. Así, según formula el propio proyecto, la IA se presenta como un sistema diseñado y moldeado por personas, y no como una caja negra opaca (6).
Para el equipo directivo. Dos criterios antes de adoptar cualquier herramienta. El primero lo enuncia Digital Promise sin rodeos: los sistemas cuyo funcionamiento interno no puede examinarse no deberían emplearse en decisiones de alto impacto, y merece la pena preguntarse cuáles lo son en un centro (2). El segundo es la pregunta que casi nunca se le hace al proveedor: ¿funciona igual de bien con el alumnado que tenemos nosotros (4)?
Para el claustro. La revisión sistemática de Iliana Guaranda-Arias y sus colegas de la Universidad Estatal de Milagro, en Ecuador, sitúa la identificación de sesgos entre los contenidos que debería incluir la formación del profesorado, junto al análisis de casos y la verificación de fuentes, con la advertencia de que el predominio de diseños descriptivos impide establecer causalidad (7).
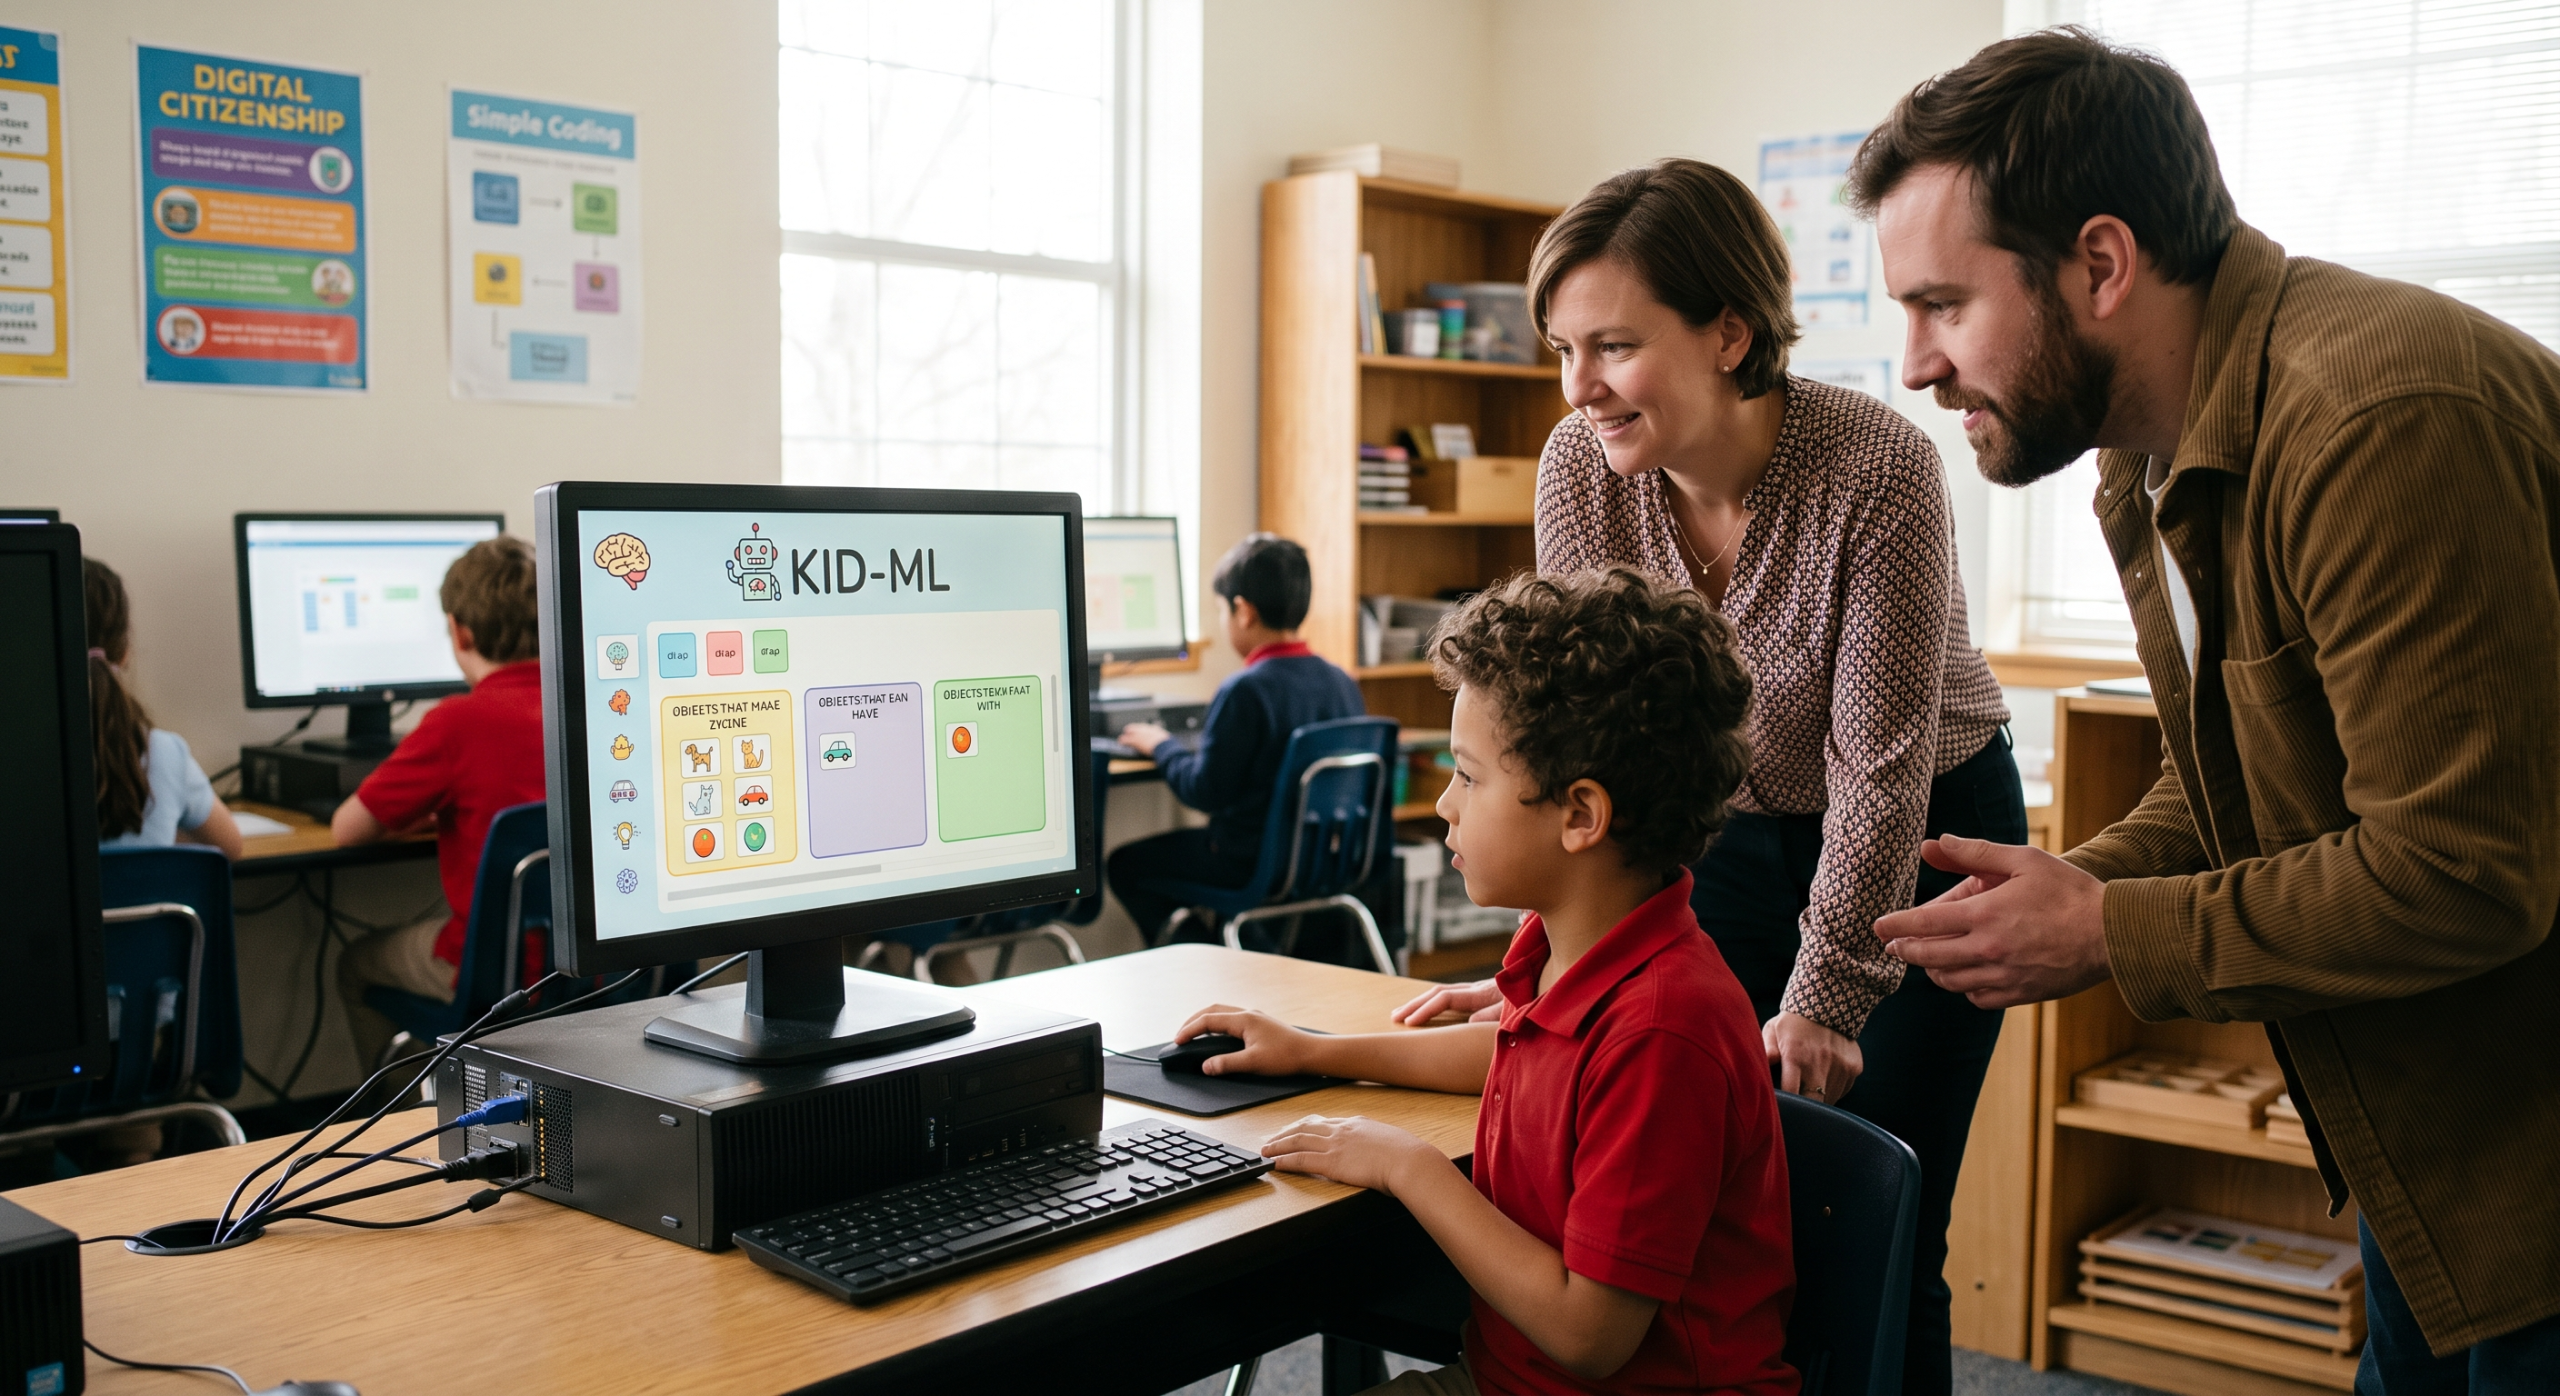
Entrenar modelos con datos propios en la escuela permite comprobar cómo se originan los errores algorítmicos.
Para terminar
El sesgo de la IA no es un fallo moral de la máquina ni la maldad de quien la programó. Es el resultado acumulado de decisiones razonables tomadas por separado: qué datos se recogen, cómo se agrupan y qué se premia al ajustar el modelo. Por eso no se corrige exigiendo buenas intenciones. Se corrige enseñando a preguntar qué falta, quién no aparece y en qué lengua se pensó esto. Es una competencia, y las competencias se enseñan.
Para seguir pensando. De nuestros alumnos, ¿quiénes están hoy en condiciones de notar lo que la herramienta ha dejado fuera, y quiénes no? Y si esa diferencia sigue la línea de lo que cada uno tiene en casa, ¿qué parte puede compensar el centro este curso?
El sesgo se corrige enseñando a preguntar quién no aparece y qué datos faltan.
Glosario
- Sesgo algorítmico. Distorsión sistemática en los resultados de un sistema informático que favorece o perjudica a determinados grupos, sin que nadie lo haya dispuesto de forma explícita.
- Datos de entrenamiento. Conjunto de textos, imágenes o registros a partir de los cuales un sistema aprende patrones. Lo que no está en ellos, para el sistema no existe.
- Representatividad. Grado en que los datos de entrenamiento reflejan la diversidad real de las personas y situaciones sobre las que el sistema va a operar.
- Variable sustituta. Dato que no nombra una característica protegida pero funciona en su lugar. El código postal puede sustituir al origen social sin mencionarlo.
- Caja negra. Sistema cuyo funcionamiento interno no puede examinarse desde fuera, de modo que se conocen las entradas y las salidas, pero no el camino entre ambas.
- Acceso epistémico. Frente al acceso material, que consiste en disponer de la herramienta, es la posibilidad de comprender los supuestos que la herramienta incorpora y someterlos a discusión.
Referencias
- OCDE y Comisión Europea (2026). Cómo preparar a los alumnos para la era de la IA. Marco de Alfabetización en IA.
- Mills, K. y otros (2024). AI Literacy: A Framework to Understand, Evaluate, and Use Emerging Technology. Digital Promise.
- Roe, J., Furze, L. y Perkins, M. (2026). Digital plastic: a metaphorical framework for Critical AI Literacy in the multiliteracies era. Pedagogies: An International Journal, 21(2), 185-199.
- Informe ODITE 2026. Claves para una nueva educación. Espiral, Educación y Tecnología. Capítulos de Carles Sierra, Miquel Àngel Fuentes Arjona y Olga Armengol Pastallé.
- Hallström, J., Mannila, L., Nordlöf, C., Heintz, F., Sperling, K. y Stenliden, L. (2026). AI literacy for K–12 education: an international Delphi study. Interactive Learning Environments.
- Generation AI (2023-2026). Proyecto de investigación financiado por el Consejo de Investigación de Finlandia. Ficha de la aplicación Teachable Machine. https://www.gen-ai.fi/en/tools/tm
- Guaranda-Arias, I. y otros (2026). Alfabetización ética en inteligencia artificial y pensamiento crítico docente: revisión sistemática. Innova Science Journal, 4(3).
Valora el post
Te puede interesar